« À partir de quel moment mon texte devient un texte IA ? » C’est la question qu’un internaute posait lundi soir sur X, quelques heures après l’annonce d’OpenAI : dans les prochaines semaines, les textes de ChatGPT et de Codex porteront en Europe un filigrane invisible, baptisé textGrain. Le raisonnement de cet internaute est simple, et il tape juste : il écrit un brouillon, demande à ChatGPT de corriger ses fautes, reprend deux formulations, en jette trois autres, et à la fin il ne sait plus lui-même qui a écrit quoi.
Eh bien, OpenAI non plus. Et c’est même écrit noir sur blanc dans son annonce. Le filigrane peut dire « un modèle d’OpenAI a probablement produit ou traité une partie de ce texte ». Il ne peut pas dire qui a réfléchi, combien tu as retouché, ni si tu as enfreint la moindre règle.
Du coup, ce billet fait le tri entre ce qui est confirmé, ce qui est faux, et ce qu’OpenAI n’a tout simplement pas dit. Je me suis appuyé sur l’annonce d’OpenAI et son article du Help Center, et sur la presse française qui a relayé la nouvelle (KultureGeek, World Is Small, Lefilia). Pour situer l’usage en France, j’ai pris le Baromètre du numérique du CRÉDOC et l’enquête Ipsos pour l’EPITA, sans oublier les réactions francophones sur X. Quand une info est confirmée, je te le dis. Quand elle l’est pas, je te le dis aussi, parce qu’une bonne partie de ce qui circule est de la supposition présentée comme un fait.
textGrain, c’est quoi exactement ?
Un filigrane dans un texte, ça sonne comme quelque chose qu’on peut voir ou sélectionner. Sauf que non. OpenAI le décrit dans son Help Center comme « un changement invisible dans le hasard utilisé pour choisir les mots du modèle ».
Version courte : quand ChatGPT écrit une phrase, il choisit en permanence entre des mots qui iraient tous très bien. Genre « commencer » ou « démarrer », « grand » ou « énorme », « mais » ou « pourtant ». La plupart du temps, c’est presque un pile ou face. textGrain oriente ces pile ou face avec une clé secrète. Sur quelques centaines de mots, ça forme un motif statistique, qu’un détecteur connaissant la clé peut aller chercher. Toi, côté lecteur, tu vois un texte tout à fait normal.
Trois conséquences, et elles expliquent presque tout le reste :
- Le signal est dans le choix des mots, pas dans des caractères cachés. D’après le Help Center, textGrain n’ajoute ni caractère caché, ni espace invisible, ni ponctuation bizarre. Copier-coller dans Word ou Google Docs l’enlève donc pas, et un outil « supprimer les caractères invisibles » sert à rien. (Il y a eu en 2025 des histoires de caractères spéciaux repérés dans des textes de ChatGPT. C’était un procédé beaucoup plus simple, sans rapport avec textGrain.)
- Il lui faut de la longueur. Une phrase seule a trop peu de choix de mots pour former un motif. Quelques centaines de mots, en revanche, suffisent.
- Changer les mots, c’est changer la preuve. Si tu réécris le passage, tu remplaces justement les choix dont le motif est fait.
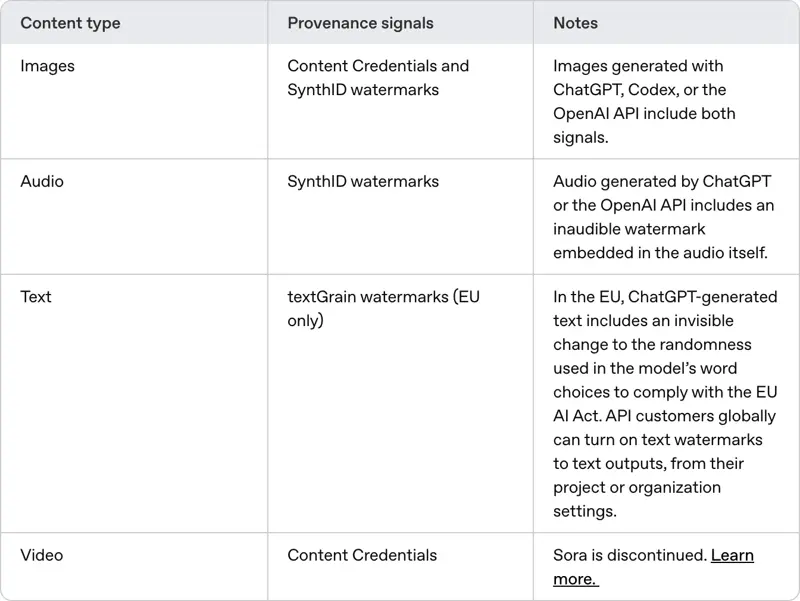
Pour les images et l’audio, OpenAI utilise déjà des filigranes (SynthID, de Google DeepMind) et des Content Credentials. Le texte est la nouveauté, et c’est le premier cas où le détecteur n’est volontairement pas public.
Ce qu’OpenAI a annoncé le 5 octobre (les faits confirmés)
Tout ce qui est dans ce tableau vient de l’annonce d’OpenAI et de son article du Help Center. TechCrunch, KultureGeek et World Is Small relaient les mêmes chiffres.
| Question | Ce que dit OpenAI |
|---|---|
| Qui reçoit du texte filigrané par défaut ? | Le texte « éligible » de ChatGPT et de Codex « dans l’Union européenne », tous forfaits confondus |
| Quand ? | « Over the coming weeks », donc dans les prochaines semaines. Pas de date précise : ton compte n’est peut-être pas encore concerné |
| C’est mondial ? | Non. OpenAI ne fait pas du filigrane de texte « un réglage mondial par défaut au lancement » |
| Et l’API ? | Les développeurs du monde entier peuvent l’activer dès le 5 octobre sur des « modèles sélectionnés ». Désactivé par défaut |
| Où l’active-t-on ? | Dans les paramètres du projet ou de l’organisation (d’après le Help Center) |
| Puis-je faire vérifier un texte ? | Pas publiquement. Détecteur réservé aux « chercheurs et organisations expertes » agréés |
| Ça m’identifie ? | Non. Selon OpenAI, le filigrane ne relie le texte ni à une personne, ni à un compte, ni à un prompt, ni à une conversation |
| Ça dégrade la qualité ? | OpenAI ne voit aucune différence notable sur ses benchmarks |
| Ce sera open source ? | OpenAI dit vouloir publier la technologie en open source, sans date |
| Pourquoi maintenant ? | Les règles de transparence de l’AI Act, applicables depuis le 2 août 2026 |
Bon, quelques points sur lesquels je m’arrête.
En UE oui, ailleurs non. OpenAI dit qu’il ne fait pas du filigrane de texte « un réglage mondial par défaut au lancement » et que cette approche régionale lui donne « de la marge pour apprendre de l’usage réel ». En gros, si tu utilises ChatGPT depuis les États-Unis, l’annonce ne te place pas dans le déploiement par défaut. Seule exception : le texte venant d’une appli bâtie sur l’API d’OpenAI dont le développeur a activé l’option.
Le détecteur n’est pas un produit. OpenAI accepte les candidatures de chercheurs et d’organisations capables de l’aider à l’évaluer. Le Help Center cite parmi les partenaires John Thickstun (Cornell), Martin Vechev (ETH Zurich et INSAIT) et le Kempelen Institute. Un prof, une rédaction, un service RH, toi-même : personne ne peut rien vérifier aujourd’hui. Tout ce qu’on te propose en ligne comme « vérificateur de filigrane ChatGPT » n’utilise pas le détecteur d’OpenAI, point.
OpenAI a publié ses propres points faibles. C’est inhabituel, et franchement, ça mérite d’être salué. Du coup, on n’a pas à deviner la fragilité du filigrane.
Ça marche à quel point ? Les chiffres d’OpenAI
OpenAI a testé textGrain avec un taux cible de faux positifs de 1 %. En clair, le détecteur est réglé pour marquer à tort un texte non filigrané environ une fois sur cent. À ce réglage :
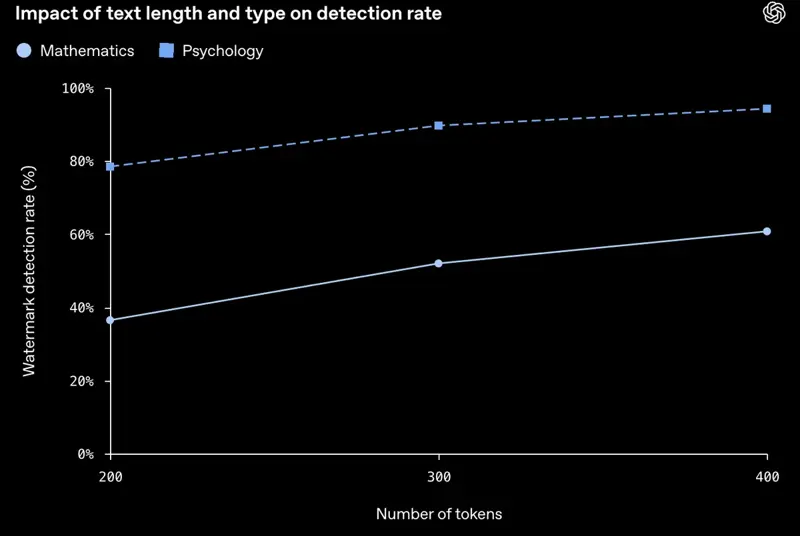
- Environ 95 % des passages de 400 tokens (à peu près 300 mots) sont détectés, pour des textes de type psychologie.
- Environ 80 % pour 200 tokens (à peu près 150 mots).
- Pour les maths, où l’on a très peu de latitude sur le choix des mots, la détection est « nettement plus basse ». Sur le graphique publié, je lis à peu près 37 % à 200 tokens et à peu près 61 % à 400.
Et là, ça devient intéressant pour quiconque retouche ses textes (donc à peu près tout le monde). Sur des passages de 400 tokens :
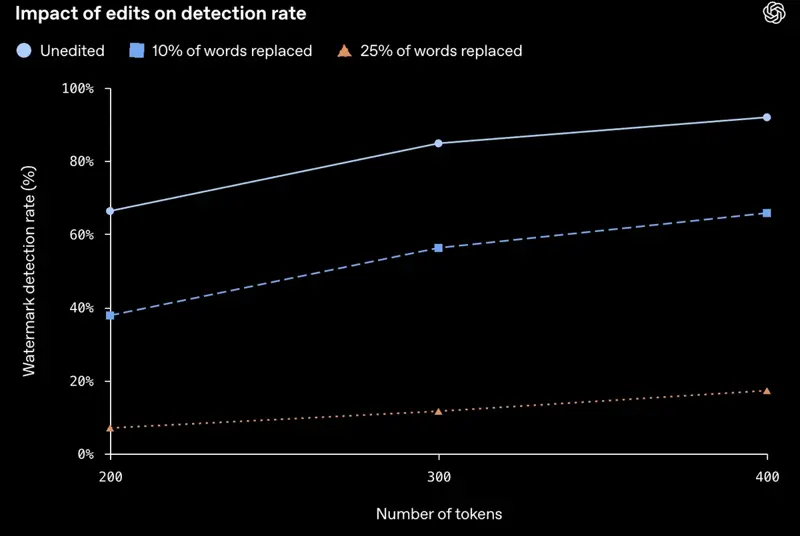
- Non modifié : environ 92 % détectés.
- 10 % des mots remplacés par des synonymes : la détection tombe à environ 66 %.
- 25 % des mots remplacés : elle tombe à environ 17 %.
Les textes traduits sont aussi plus difficiles à détecter selon OpenAI, et une réécriture poussée peut rendre le filigrane introuvable. Aucun chiffre n’est donné pour la traduction. (Pour nous, c’est loin d’être anecdotique : combien de gens passent par ChatGPT pour traduire de l’anglais, ou pour reformuler un texte déjà traduit ?)
Côté qualité, OpenAI a comparé son dernier modèle (Astra) avec et sans filigrane sur plusieurs benchmarks. L’indice d’intelligence d’Artificial Analysis donne 49,57 points sans et 49,76 avec. GPQA Diamond : 94,44 % contre 93,94 %. BrowseComp : 87,92 % contre 87,35 %. Les écarts vont dans les deux sens, et c’est à ça que ressemble « pas de différence notable » dans la vraie vie. Bon, ça dit pas forcément comment ton mail du lundi matin sera affecté, mais c’est déjà un chiffre là où on n’avait que des promesses.
Une affirmation que tu liras sûrement : dans ses tests, textGrain aurait égalé ou dépassé d’autres méthodes, SynthID pour le texte compris. Sauf qu’en fait, c’est l’évaluation d’OpenAI lui-même. Aucun test indépendant n’existait au lendemain de l’annonce.
La question qui fâche : où commence un « texte IA » ?
Reprenons la question de l’internaute. Elle est plus intéressante que toutes les polémiques sur Bruxelles, et OpenAI y répond en partie avec ses chiffres. Voici le même texte, un courrier de 300 mots (environ 400 tokens, la taille testée par OpenAI), à différents stades de retouche.
| Ce que tu as fait | Chance qu’un détecteur le repère (test OpenAI) | Ce que le filigrane dit vraiment |
|---|---|---|
| Tu colles le brouillon de ChatGPT tel quel | environ 92 sur 100 | « Un modèle OpenAI a probablement produit ce texte » |
| Tu remplaces un mot sur dix (environ 30 mots) | environ 66 sur 100 | Le signal est plus probable qu’absent, malgré ton travail |
| Tu réécris un mot sur quatre (environ 75 mots) | environ 17 sur 100 | Presque rien : la plupart des gens qui veulent « que ça sonne comme moi » vont au moins jusque-là |
| Tu écris tout toi-même et demandes juste trois virgules corrigées | Les chiffres ne s’appliquent pas | Pratiquement rien ne vient des choix du modèle : il n’a quasiment pas écrit |
Bon, la dernière ligne est la plus importante. OpenAI écrit lui-même dans son Help Center qu’un filigrane ne dit pas dans quelle mesure un modèle a participé. Il peut suggérer qu’un modèle a traité du texte. Il ne dit pas qui a pensé.
Et il y a la face B, qui compte en France, où la défiance devient vite un réflexe : le détecteur est réglé pour se tromper environ une fois sur cent sur du texte non filigrané. Si un établissement passait 300 devoirs rédigés à la main dans un détecteur pareil, il devrait s’attendre à environ trois fausses alertes (1 % de 300). Trois étudiants soupçonnés d’un truc qu’ils n’ont pas fait. C’est une des raisons pour lesquelles OpenAI ne rend pas le détecteur public « vu le risque de filigranes manqués et de faux positifs ». Et c’est aussi pour ça qu’un « positif » ne devrait jamais valoir preuve.
Qui est concerné en France ? Quelques repères
D’après le Baromètre du numérique 2026 du CRÉDOC (publié le 10 février 2026, plus de 4 000 personnes interrogées), 48 % des Français utilisent l’IA générative, soit 28 points de plus qu’en 2023. ChatGPT est utilisé par 79 % de ces utilisateurs, loin devant Gemini (31 %) et le Chat de Mistral (14 %). En croisant les deux chiffres, ça fait grosso modo quatre Français sur dix qui passent par ChatGPT (c’est mon calcul, pas une statistique du CRÉDOC). Bref, le filigrane ne vise pas une niche.
Côté études, l’enquête Ipsos pour l’EPITA (février 2026) indique que 92 % des étudiants français ont déjà utilisé l’IA dans le cadre de leurs études, et à peu près la moitié l’utilise tous les jours. Dans la même enquête, 76 % des enseignants considèrent que se servir de l’IA pour un devoir relève de la triche, contre 65 % des étudiants pour un travail entièrement rédigé par l’IA. Voilà le contexte dans lequel arrive textGrain : un terrain déjà très tendu, où les détecteurs automatiques ne sont, selon cette même source, fiables qu’à 50-60 %.
Est-ce que ça me concerne ? Le test en 6 étapes
En fait, il n’existe pas de vérificateur. « Est-ce que mon texte est filigrané ? » veut donc plutôt dire « est-ce qu’il pourrait l’être ? ». Voici comment faire.
Étape 1 : où le texte a-t-il été généré ?
- Via ChatGPT ou Codex avec un compte que tu utilises depuis l’UE : c’est le groupe qu’OpenAI dit vouloir filigraner « dans les prochaines semaines ».
- Via ChatGPT depuis l’extérieur de l’UE : OpenAI n’a annoncé aucun déploiement par défaut.
- Via une appli ou un site bâti sur l’API d’OpenAI : filigrané seulement si le développeur l’a activé, et seulement sur des « modèles sélectionnés ».
- Via Claude, Gemini ou un autre outil : règles différentes. Anthropic filigrane Claude dans le monde entier sur les modèles récents compatibles (on en parle dans notre article Filigrane de Claude vs détecteur d’IA), et le SynthID de Google est déjà dans Gemini.
Étape 2 : la date. OpenAI dit « dans les prochaines semaines », pas « aujourd’hui ». Un texte écrit avant que le déploiement n’atteigne ton compte n’est pas filigrané, et OpenAI précise que le texte antérieur au filigrane n’est pas détectable.
Étape 3 : la longueur. En gros, en dessous de 100 à 150 mots, il y a souvent trop peu de signal. Au-delà de 300 mots de sortie de modèle non retouchée, il y en a largement assez.
Étape 4 : combien as-tu modifié ? Si plus d’un quart des mots viennent de toi, un détecteur ne réagirait, d’après OpenAI, que dans environ un cas sur six. Et si tu n’as touché qu’à la ponctuation, bah, c’est pratiquement inchangé.
Étape 5 : la question du VPN. Sur X, un francophone a déjà lancé que passer par un proxy permettrait d’éviter le filigrane. Rien ne le confirme, et OpenAI n’a pas dit comment il décide qui est « utilisateur de l’UE » (IP, compte, pays de facturation ?). Les seules réponses qui circulent sont des suppositions, y compris celle d’un chatbot. Ne bâtis rien là-dessus. Et même si ça marchait, OpenAI dit vouloir réexaminer « chaque volet de cette approche ». Quant à ton école ou ton employeur, ils te demanderont de toute façon pas ton adresse IP.
Étape 6 : oublie les sites « vérificateurs ». Un site qui promet de vérifier ton texte contre le « filigrane ChatGPT » ne peut pas utiliser le détecteur d’OpenAI. En fait, c’est soit un classifieur qui devine, soit une page qui veut tes données. N’y colle rien de confidentiel.
Pourquoi l’UE, et ce que la loi exige vraiment
Tout part d’un seul article de l’AI Act. L’article 50, paragraphe 2 oblige les fournisseurs de systèmes d’IA générative à marquer leurs sorties synthétiques (texte, image, audio, vidéo) dans un format lisible par machine. Il s’applique depuis le 2 août 2026. Une exception existe pour les systèmes qui se limitent à une « assistance standard à l’édition » ou ne modifient pas substantiellement ce qu’on leur donne. C’est pour ça qu’un texte que tu as écrit toi-même et fait juste lisser reste une zone grise.
Deux dates à retenir :
- 2 août 2026 : l’article 50 s’applique. Les nouveaux systèmes sont censés démarrer avec le marquage intégré. C’est pour ça qu’Anthropic a activé son filigrane Claude ce jour-là.
- 2 décembre 2026 : fin d’une transition de quatre mois, créée par le paquet « Digital Omnibus ». Elle concerne l’obligation de marquage lisible par machine pour les systèmes déjà sur le marché avant le 2 août. D’ailleurs, c’est ce qui explique qu’OpenAI déploie textGrain « sur les prochaines semaines » plutôt que du jour au lendemain.
Autour de la loi, il y a un code de bonnes pratiques sur la transparence des contenus générés par l’IA, publié par la Commission européenne le 10 juin 2026. Il est volontaire. La première liste de signataires, publiée le 31 juillet, comptait environ 190 organisations, dont OpenAI, Anthropic, Google, Microsoft, Meta et Mistral AI. OpenAI écrit dans son Help Center que son filigrane de texte est conforme à ses engagements dans ce code.
Côté contrôle, d’après un décryptage juridique français, la surveillance de l’AI Act en France reposerait sur une architecture partagée entre la CNIL, la DGCCRF et l’Arcom selon les sujets, avec des amendes pouvant aller jusqu’à 15 millions d’euros ou 3 % du chiffre d’affaires mondial. D’ailleurs, ça vise les fournisseurs et les entreprises qui publient des contenus IA, pas toi quand tu utilises ChatGPT pour toi.
Ce que la loi ne fait pas : elle n’impose pas de bandeau visible « écrit par une IA » sur chaque document assisté par IA, et elle ne transforme pas un filigrane détecté en preuve juridique de triche. Pour les textes d’intérêt public publiés, une obligation d’information peut s’appliquer, sauf si une personne les a relus et qu’un responsable éditorial assume la publication.
textGrain, Claude et Gemini côte à côte
En fait, les trois grands assistants utilisent désormais une variante de la même idée. Ils diffèrent sur qui est touché et qui peut vérifier.
| OpenAI (ChatGPT, Codex) | Anthropic (Claude) | Google (Gemini) | |
|---|---|---|---|
| Méthode | textGrain (signal statistique dans le choix des mots) | Variante du SynthID-Text de Google, selon Anthropic | SynthID-Text |
| Où ça s’applique | ChatGPT et Codex en UE, « dans les prochaines semaines » ; API en option dans le monde | Modèles récents compatibles, monde entier, depuis le 2 août | Déjà en place dans Gemini |
| Par défaut ou en option | Par défaut en UE, désactivé par défaut dans l’API | Par défaut | Par défaut |
| Détecteur public ? | Non. Chercheurs et organisations expertes | Annoncé comme à venir | Détecteur de référence proposé aux développeurs |
| Faiblesses publiées | Oui : chiffres sur la retouche et la longueur | Anthropic prévient qu’un positif n’est pas une preuve d’auteur | Google prévient que réécrire ou traduire réduit la confiance |
« OpenAI filigrane tout », c’est donc exagéré. Celui de Claude est le plus étendu. Celui d’OpenAI est le plus prudent, le plus régional, et le seul dont le fournisseur a publié dès le premier jour des chiffres sur la robustesse. Un internaute résumait : peut-on vraiment s’indigner que l’Europe fasse jouer les entreprises étrangères selon ses règles, alors que Google et Anthropic ont déployé le leur directement à l’échelle mondiale ? Franchement, l’argument n’est pas idiot.
Gadget de conformité ou vrai outil ? Mon avis
Sur X en français, deux camps se répondent. D’un côté : « encore une masterclass de l’Europe », « les outils réservés aux chercheurs », « c’est idiot alors qu’il existe plein de modèles open source ». De l’autre : un internaute qui se demande simplement pourquoi ce ne serait pas une bonne idée. Et entre les deux, celui qui résume le fond du problème : la frontière humain/IA est déjà floue. Bref, chacun a un peu raison.
Là où la critique tape juste. Les chiffres sont sobres. Celui qui veut se débarrasser du filigrane y arrive en réécrivant, et OpenAI l’écrit lui-même. Les chercheurs avertissent aussi : l’équipe de Martin Vechev à l’ETH Zurich a montré dans « Watermark Stealing » qu’on peut, en interrogeant un modèle filigrané, reconstituer assez de ses règles cachées pour effacer ou falsifier le marquage. Résultat : plus de 80 % de réussite en moyenne, pour moins de 50 dollars, dans les montages testés. Le plus embêtant, c’est la falsification : si quelqu’un peut faire passer un texte étranger pour filigrané, un positif n’est plus une preuve fiable. C’était testé sur d’autres procédés, pas sur textGrain, mais ça montre où va le débat.
Là où elle va trop loin. Un filigrane, c’est pas un antifraude, et ça n’a jamais été conçu comme détecteur de mensonge. Pour les régulateurs, l’objectif est ailleurs : permettre aux plateformes et aux chercheurs de repérer de gros volumes de texte machine non retouché, spam, réseaux de bots, production de masse où personne ne prend la peine de reformuler. Pour ça, un signal détecté à 92 % sur du texte brut suffit largement.
Et le RGPD, dans tout ça ? Réflexe bien français : la question des données personnelles arrive tout de suite. Selon OpenAI, le filigrane ne relie le texte ni à une personne, ni à une organisation, ni à un compte, ni à un prompt, ni à une conversation, et le détecteur indique seulement s’il trouve un filigrane OpenAI, sans révéler l’utilisateur ni ses requêtes. C’est une déclaration du fournisseur, qu’on ne peut pas vérifier de façon indépendante. Ça colle quand même avec la technique : le motif vient du choix des mots et ne contient pas de données utilisateur intégrées. Si tu colles des données personnelles dans ChatGPT, tu as un sujet RGPD qui n’a rien à voir avec le filigrane. Ça se traite dans le cours Conformité RGPD et IA Act.
Ce que ça change pour toi
Sept situations, chacune avec une recommandation et une première action.
Si tu es étudiant. Ton texte ChatGPT peut porter un filigrane dans les prochaines semaines, mais aucune université ne peut le vérifier aujourd’hui, et OpenAI dit qu’un positif prouve seulement qu’un modèle a traité le texte. En fait, le risque n’est pas le filigrane. Le risque, c’est de rendre un texte IA en le faisant passer pour le tien alors que ton règlement l’interdit. Première action : relis cette semaine la charte IA de ton école ou de ta fac, et note ce que tu as le droit de faire avec l’IA. Le cours L’IA pour les Étudiants t’aide.
Si tu enseignes. Tu peux pas utiliser ce détecteur, et un positif trancherait de toute façon pas un cas. Ce qui tient mieux, c’est le processus : avec des devoirs qui montrent la pensée dans le temps, des brouillons, l’historique des versions, un échange sur le texte. Première action : formule une règle claire sur l’IA pour ton cours. Le cours L’IA pour les Enseignants montre comment.
Si tu écris pour vivre (rédacteur, agence, équipe contenu). Tes clients te demanderont si ton texte est généré par IA. Un filigrane ne répond pas à « qui a pensé ? », et OpenAI le dit lui-même. À la publication, l’article 50, paragraphe 4, peut en plus s’appliquer. Première action : fixe dès maintenant ta ligne de transparence (modèle plus bas), plutôt que de te justifier après coup. Des outils pour ça dans le cours Rédaction Professionnelle avec l’IA.
Si tu cherches un emploi. Une lettre de motivation dont le brouillon vient de ChatGPT n’a pas d’obligation de mention, aucun recruteur ne peut vérifier textGrain aujourd’hui, et un texte retravaillé perd l’essentiel du signal de toute façon. Ce qui nuit vraiment aux candidatures, c’est le texte IA générique, non retouché. Première action : réécris au moins un quart de ton brouillon avec tes mots, ajoute une histoire concrète que toi seul peux raconter, et garde ta propre version. Le cours Trouver un Emploi grâce à l’IA montre une méthode plus rapide.
Si tu es développeur ou que tu gères une appli sur l’API d’OpenAI. Là, tu as un choix que l’utilisateur de ChatGPT n’a pas. L’option est désactivée par défaut et s’active dans les paramètres du projet ou de l’organisation pour les modèles compatibles. Première action : décide si tes utilisateurs ont besoin d’un justificatif de provenance (conformité, éditeurs, secteurs régulés) et teste l’option sur un projet de préproduction avant de promettre quoi que ce soit à tes clients.
Si tu diriges une PME ou publies des contenus IA. C’est là que l’obligation d’information est la plus susceptible de jouer, surtout si tes textes touchent à des sujets d’intérêt public. Première action : écris une phrase de responsabilité éditoriale dans ton process (qui relit avant de publier ?) et passe par le cours AI Act : conformité entreprises 2026.
Si tu travailles aux RH. N’écarte jamais un candidat sur un seul positif de filigrane : il ne dit rien de la part humaine du texte. Pour le recrutement, d’autres règles européennes s’appliquent, expliquées dans IA Act et recrutement : le délai a bougé, pas les obligations. Première action : écris dans tes critères de sélection que des traces d’IA ne sont pas un motif d’exclusion, tout au plus une raison d’ouvrir la discussion.
Un modèle : la note d’usage de l’IA
Bon, la meilleure réaction aux filigranes n’est pas de les combattre. C’est de garder une trace propre de la façon dont tu as utilisé l’IA, pour qu’un résultat de détecteur, juste ou faux, ne soit jamais ta seule preuve. Copie ça et adapte.
Note d'usage de l'IA (à ranger avec le fichier final)

Document : [titre]
Date : [date]
Outils utilisés : [ChatGPT / Claude / Gemini / aucun]
Ce que l'IA a fait : [plan | corrections de grammaire | brouillon des parties 2 et 4 | traduction | rien]
Ce que j'ai fait moi-même : [idées, structure, exemples, relecture finale, vérification des faits]
Où sont les brouillons : [historique des versions Google Docs / fichier Word / dossier]
Sources que j'ai vérifiées moi-même : [liste]
Range-la dans le même dossier que tes brouillons. Si on te demande quelque chose, du coup, tu montres un historique daté plutôt que de débattre d’une statistique.
Cas particuliers et dépannage
Voici les questions et problèmes apparus dans les 24 premières heures.
« Je contourne ça avec un VPN ? » Voir l’étape 5 : rien n’est confirmé, et c’est pas un bon plan. OpenAI dit en plus que l’approche régionale est provisoire.
« Un texte que j’ai écrit et fait juste lisser par ChatGPT porte-t-il le filigrane ? » Peut-être en partie. Un modèle qui reformule tes phrases utilise ses propres choix de mots pour ces phrases. Mais bon, OpenAI dit qu’un positif ne dit rien de la part humaine. Si cette distinction compte pour toi, la note d’usage de l’IA est le bon moyen de la prouver.
« Copier dans Word ou Google Docs enlève-t-il le filigrane ? » Non. Le signal est dans le choix des mots, pas dans des caractères invisibles. Le Help Center cite le copier-coller parmi les modifications auxquelles textGrain doit résister. Retaper phrase par phrase avec tes mots l’affaiblit, parce que tu remplaces les choix.
« Et si je traduis le texte ? » OpenAI dit que le texte traduit est plus difficile à détecter. Il n’y a pas de chiffre. Considère « traduit, donc non marqué » comme probable mais non prouvé, et signale l’aide à la traduction là où tes règles l’exigent.
« Le code écrit par Codex est-il marqué ? » OpenAI dit que le texte de Codex est couvert. Mais bon, le code laisse peu de latitude, et le graphique d’OpenAI montre que pour les contenus peu flexibles (comme les maths), la détection est nettement plus faible. Dans les commentaires et la documentation, le signal devrait être plus fort que dans le code lui-même.
« Un site dit pouvoir vérifier mon texte contre le filigrane ChatGPT. » Il n’utilise pas le détecteur d’OpenAI. N’y mets rien de confidentiel.
« Un “humanizer” ou un “remover” promet d’enlever le filigrane. » Certains peuvent l’atténuer, parce qu’une réécriture poussée l’affaiblit. Mais tu ne peux pas vérifier le résultat, et la réécriture peut abîmer ton texte ou y glisser des erreurs. Si ton but est un texte qui sonne comme toi, le retravailler à la main est plus économique et plus sûr.
« Un détecteur a marqué un texte que j’ai écrit moi-même. » Garde ton calme et demande des précisions : quel détecteur, quel seuil, quelle longueur, quelles autres preuves que le score. Un résultat de filigrane est un indice, pas un verdict. Viens avec tes brouillons et l’historique des versions.
Ce que textGrain ne peut pas faire
- Il ne prouve pas qu’un humain a écrit. OpenAI le dit en toutes lettres : l’absence de filigrane détecté ne prouve pas la paternité humaine. Le texte peut être trop court, retouché, traduit, venir d’un autre fournisseur ou d’avant le déploiement.
- Il ne dit pas qui a réfléchi. Un filigrane ne mesure pas la part humaine. Quelqu’un qui a eu toutes les idées et fait corriger la grammaire ressemble, pour un détecteur, à quelqu’un qui a collé un prompt.
- Il ne t’identifie pas. Selon OpenAI, il ne relie le texte ni à une personne, ni à un compte, ni à un prompt, ni à une conversation.
- Il ne survit pas à une retouche déterminée. À un quart de mots remplacés, la détection d’OpenAI tombe à 17 %.
- Il ne fait pas preuve en cas de litige. Les faux positifs existent (environ 1 % au réglage testé), des attaques de falsification ont été montrées sur d’autres procédés, et le détecteur n’a pas encore été évalué de façon indépendante.
Ce qu’il peut faire : aider plateformes et chercheurs à repérer de gros volumes de texte machine non retouché, comme le spam, les réseaux de bots et la production de masse. C’est plus proche de ce que veulent les régulateurs que de piéger un devoir isolé.
FAQ
ChatGPT filigrane-t-il maintenant tous mes textes ? Non. OpenAI dit qu’il ajoutera un filigrane invisible au texte éligible de ChatGPT et de Codex dans l’UE, dans les prochaines semaines. Ce n’est pas un réglage mondial par défaut. Les clients de l’API du monde entier peuvent l’activer sur des modèles sélectionnés, mais l’option est désactivée par défaut.
C’est quoi textGrain ? La méthode de filigrane de texte d’OpenAI. Elle oriente les choix aléatoires du modèle entre mots proches, pour qu’un détecteur muni d’une clé secrète puisse ensuite retrouver un motif statistique. Elle n’ajoute ni marque visible ni caractère caché.
Quelqu’un peut-il vérifier si mon texte a le filigrane ? Pas aujourd’hui. OpenAI réserve le détecteur, au lancement, à des chercheurs et organisations expertes agréés. Les sites qui proposent de tester textGrain n’utilisent pas le détecteur d’OpenAI.
Le filigrane révèle-t-il qui je suis ou ce que j’ai écrit comme prompt ? Selon OpenAI, non. Le filigrane ne relie pas le texte à une personne, une organisation, un compte, un prompt ou une conversation, et le détecteur signale seulement s’il trouve un filigrane OpenAI.
Puis-je le désactiver ? En fait, l’annonce d’OpenAI ne décrit aucun réglage utilisateur pour ChatGPT dans l’UE. L’entreprise dit vouloir, « quand c’est possible », donner le choix. Les clients de l’API peuvent l’activer dans les paramètres du projet ou de l’organisation. Que ce soit « impossible à désactiver » n’est ni confirmé ni infirmé par les pages d’OpenAI.
Retoucher le texte enlève-t-il le filigrane ? Ça l’affaiblit. Dans le test d’OpenAI sur des textes de 400 tokens, la détection est passée d’environ 92 % à environ 66 % avec 10 % de mots remplacés, et à environ 17 % avec 25 %. Une réécriture poussée ou une traduction peut le rendre introuvable.
Mon prof ou mon employeur peut-il m’attraper avec ça ? Pas avec le détecteur d’OpenAI, auquel ils n’ont pas accès. Et même s’ils l’avaient, OpenAI dit qu’un résultat n’indique ni la part humaine du texte, ni à qui il appartient, ni si une règle a été violée.
Le filigrane de Claude est-il différent ? Oui. Anthropic dit que son filigrane, une variante du SynthID-Text de Google, s’applique dans le monde entier sur les modèles Claude récents compatibles, pas seulement dans l’UE. Celui d’OpenAI est régional et son détecteur est restreint. Détails dans notre article sur le filigrane de Claude.
Pourquoi l’UE d’abord ? Parce que l’article 50, paragraphe 2, de l’AI Act oblige depuis le 2 août 2026 les fournisseurs à marquer le texte synthétique de façon lisible par machine. Un délai jusqu’au 2 décembre 2026 pour les systèmes déjà sur le marché explique le déploiement progressif.
Dois-je arrêter d’écrire avec ChatGPT ? Non. Le risque pratique n’est pas le filigrane, c’est de faire passer l’aide d’une IA pour ton propre travail là où tes règles l’interdisent. Utilise l’IA, retravaille le texte pour qu’il soit vraiment à toi, garde tes brouillons et respecte les règles de ton école ou de ton employeur.
En résumé
En fait, textGrain est un vrai changement, mais plus petit et plus prudent que ne le laissent croire les gros titres. Les textes de ChatGPT et de Codex en UE recevront dans les prochaines semaines un signal statistique invisible. Hors de l’UE, tu ne fais pas partie du déploiement par défaut. À part un petit groupe de chercheurs agréés, personne ne peut le vérifier. Et les chiffres d’OpenAI montrent à quelle vitesse il s’efface : une détection d’environ 17 % quand un quart des mots change.
Bref, ni panique, ni bidouille. Comprends ce que c’est, respecte les règles qui te lient vraiment, et documente la manière dont tu as utilisé l’IA. Une courte note d’usage et un dossier de brouillons datés valent mieux que n’importe quel résultat de filigrane, pour toi comme contre toi.
Pour utiliser l’IA en confiance au boulot comme en cours : Les Fondamentaux de l’IA explique ce que ces outils font et ne font pas, AI Act : conformité entreprises 2026 décortique les règles sans jargon juridique, et Conformité RGPD et IA Act t’aide sur les questions de données personnelles, qui n’ont rien à voir avec le filigrane mais comptent au moins autant. Pour comprendre la différence entre un filigrane et un détecteur d’IA, notre entrée de glossaire What Is an AI Text Watermark? (en anglais) fait le tour.
Sources
- OpenAI, « Our approach to EU text provenance rules » (5 octobre 2026)
- OpenAI Help Center, « Provenance signals in OpenAI-generated content »
- OpenAI, rapport technique textGrain « Entropy-calibrated watermarking for language model text »
- KultureGeek, « ChatGPT va intégrer un filigrane invisible dans ses textes générés par IA »
- World Is Small, « OpenAI va ajouter un filigrane numérique aux textes et au code générés dans l’Union européenne » (5 octobre 2026)
- Lefilia, « OpenAI ajoute un filigrane textuel dans ChatGPT et Codex »
- TechCrunch, « OpenAI will start watermarking ChatGPT’s text in the EU » (5 octobre 2026)
- Blog du Modérateur, « IA générative : 48 % des Français l’utilisent, une adoption record » (Baromètre du numérique 2026 du CRÉDOC)
- Planète Grandes Écoles, sur l’enquête Ipsos pour l’EPITA (février 2026)
- donneespersonnelles.fr, « Transparence IA : article 50 de l’AI Act »
- Korben, « Claude va glisser un filigrane invisible dans tous ses textes »
- AI Act, article 50 : obligations de transparence
- Conseil de l’Europe/MERLIN, code de bonnes pratiques sur la transparence des contenus générés par l’IA
- Cloud Security Alliance, note sur l’échéance de l’article 50 en décembre 2026
- Jovanović, Staab et Vechev (ETH Zurich), « Watermark Stealing in Large Language Models »
- Google DeepMind, SynthID-Text (Nature)