«¿Esto es para todos o solo para los pobrecitos de la UE?» Eso le preguntó un usuario a Grok el lunes por la noche, unas horas después de que OpenAI anunciara que los textos de ChatGPT y Codex llevarán una marca de agua invisible. Ocho minutos después volvió con la segunda pregunta, la que de verdad importa: si desde el continente americano esto no le afecta en nada.
Las dos preguntas tienen respuesta, y la respuesta es más matizada que cualquier titular. La marca se llama textGrain. Llega «en las próximas semanas» a los usuarios de ChatGPT y Codex en la Unión Europea. Fuera de la UE, no es el comportamiento por defecto. Y lo más curioso: OpenAI publicó con cifras lo fácil que es hacerla desaparecer.
En este artículo te cuento qué anunció OpenAI exactamente y a quién afecta (España incluida, y también qué significa si estás en México, Colombia, Argentina o Chile). Después vemos qué puede y qué no puede probar una marca de agua, y qué conviene hacer, seas estudiante, redactor, freelancer o simplemente alguien que usa ChatGPT para sus correos. Me apoyé en el anuncio de OpenAI y su artículo del Help Center, en la cobertura de Hipertextual y otros medios en español, en la encuesta TIC del INE y en las reacciones en español en X. Cuando algo está confirmado, te lo digo. Cuando OpenAI no lo dijo (y hay bastante), también te lo digo, porque una parte de lo que circula es pura suposición.
Qué es textGrain (sin humo)
Una marca de agua en un texto suena a algo que se puede ver o seleccionar. textGrain no es eso. OpenAI lo describe en su Help Center como «un cambio invisible en el azar que el modelo usa para elegir sus palabras».
La versión corta: cuando ChatGPT escribe una frase, va eligiendo todo el tiempo entre palabras que encajarían igual de bien. «Empezar» o «comenzar», «grande» o «enorme», «pero» o «sin embargo». La mayoría de las veces es casi echar una moneda al aire. textGrain inclina esa moneda con una clave secreta. A lo largo de unos cientos de palabras, eso forma un patrón estadístico que un detector con la clave puede ir a buscar. Tú, como lector, ves un texto de lo más normal.
Tres consecuencias, y con ellas se entiende casi todo lo demás:
- La marca está en la elección de palabras, no en caracteres ocultos. Según el Help Center, textGrain no agrega caracteres ocultos, espacios invisibles ni signos de puntuación raros. O sea, copiar y pegar en Word o en Google Docs no la quita, y una herramienta de «eliminar caracteres invisibles» no sirve de nada. (En 2025 circularon historias sobre caracteres especiales en textos de ChatGPT. Era un truco mucho más simple y no tiene nada que ver con textGrain.)
- Necesita longitud. Una frase suelta tiene muy pocas decisiones de palabras para formar un patrón. Unos cientos de palabras sí alcanzan.
- Si cambias las palabras, cambias la evidencia. Si reescribes el pasaje, estás reemplazando justo las decisiones de las que está hecho el patrón.
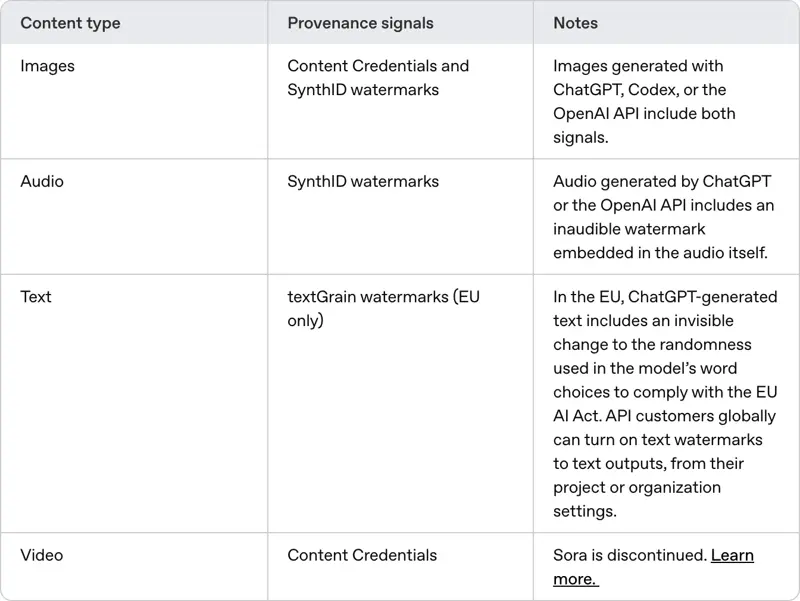
En imágenes y audio, OpenAI ya usa marcas de agua (SynthID, de Google DeepMind) y Content Credentials. El texto es lo nuevo, y es el primer caso en el que el detector, a propósito, no es público.
Qué anunció OpenAI el 5 de octubre (lo confirmado)
Todo lo de esta tabla sale del anuncio de OpenAI y de su artículo del Help Center. TechCrunch y Hipertextual repiten las mismas cifras.
| Pregunta | Qué dice OpenAI |
|---|---|
| ¿Quién recibe texto con marca por defecto? | El texto «elegible» de ChatGPT y Codex «en la Unión Europea», en todos los planes |
| ¿Cuándo? | «Over the coming weeks», o sea, en las próximas semanas. No hay fecha exacta: tu cuenta quizá todavía no esté incluida |
| ¿Es global? | No. OpenAI no hace de la marca de agua de texto «un ajuste global por defecto al lanzamiento» |
| ¿Y la API? | Los desarrolladores de cualquier país pueden activarla desde el 5 de octubre en «modelos seleccionados». Viene apagada |
| ¿Dónde se activa en la API? | En los ajustes del proyecto o de la organización (según el Help Center) |
| ¿Puedo revisar un texto? | No públicamente. Detector solo para «investigadores y organizaciones expertas» aprobados |
| ¿Me identifica? | No. Según OpenAI, no vincula el texto con una persona, cuenta, prompt ni conversación |
| ¿Afecta la calidad? | OpenAI no ve diferencias importantes en sus benchmarks |
| ¿Será de código abierto? | OpenAI dice que planea publicar la tecnología como open source, sin fecha |
| ¿Por qué ahora? | Las reglas de transparencia del AI Act, aplicables desde el 2 de agosto de 2026 |
Bueno, hay unos puntos en los que me quiero detener.
En la UE sí, en el resto no (por ahora). OpenAI dice que no hace de la marca de agua de texto «un ajuste global por defecto al lanzamiento» y que el enfoque regional le da «margen para aprender del uso real». Hipertextual lo resume diciendo que la medida debutará «pronto en España y el resto de la Unión Europea». Si usas ChatGPT desde América, el anuncio no te pone en el despliegue por defecto. La excepción: texto que sale de una app construida sobre la API de OpenAI, cuyo desarrollador haya activado la opción.
El detector no es un producto. OpenAI recibe solicitudes de investigadores y organizaciones que puedan ayudarle a evaluarlo. El Help Center menciona entre sus socios a John Thickstun (Cornell), Martin Vechev (ETH Zúrich e INSAIT) y el Kempelen Institute. Un docente, una redacción, un departamento de RR. HH. o tú mismo no pueden verificar nada hoy. Cualquier cosa que te ofrezcan en internet como «verificador de la marca de ChatGPT» no usa el detector de OpenAI.
OpenAI publicó sus propias debilidades. Es raro, y la verdad es que merece un reconocimiento. Significa también que no hace falta adivinar qué tan frágil es.
¿Qué tan bien funciona? Las cifras de OpenAI
OpenAI probó textGrain con una tasa objetivo de falsos positivos del 1 %. Es decir, el detector está calibrado para marcar por error un texto sin marca más o menos una vez de cada cien. Con esa configuración:
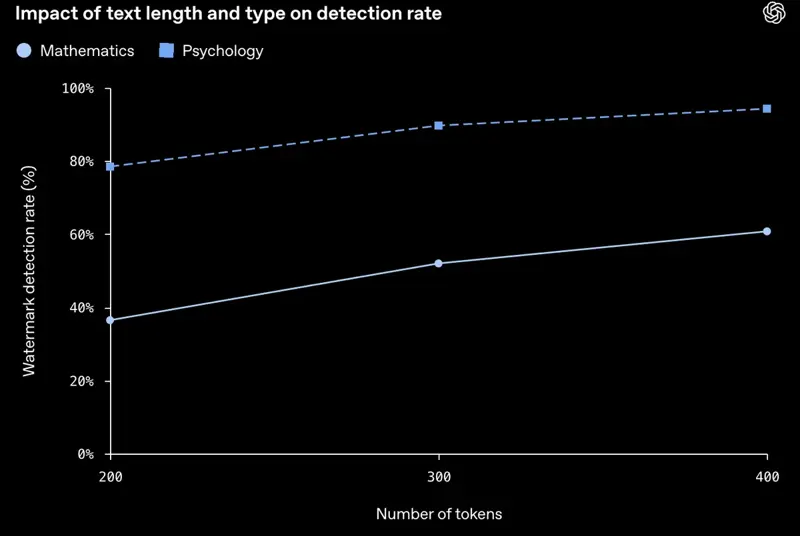
- Cerca del 95 % de los pasajes de 400 tokens (unas 300 palabras) se detectaron, en textos tipo psicología.
- Cerca del 80 % con 200 tokens (unas 150 palabras).
- En matemáticas, donde casi no hay margen para elegir palabras, la detección es «sustancialmente más baja». En la gráfica que publicó OpenAI leo más o menos 37 % a 200 tokens y 61 % a 400.
Y ahora lo que importa para cualquiera que edite sus textos (o sea, casi todo el mundo). En pasajes de 400 tokens:
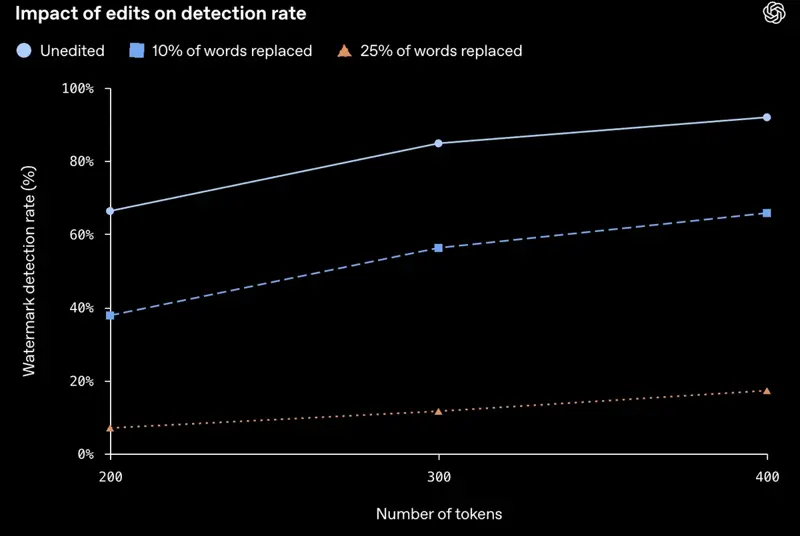
- Sin editar: cerca del 92 % detectado.
- Con el 10 % de las palabras cambiadas por sinónimos: la detección baja a cerca del 66 %.
- Con el 25 % de las palabras cambiadas: baja a cerca del 17 %.
Según OpenAI, el texto traducido también es más difícil de detectar, y una reescritura fuerte puede dejar la marca indetectable. No dio ninguna cifra para traducciones. (Aquí hay un detalle que a nosotros nos toca de cerca: mucha gente pasa textos del inglés al español con ChatGPT, o reformula textos que ya venían traducidos, y justo eso cae en la zona gris.)
Sobre la calidad: OpenAI comparó su modelo más nuevo (Astra) con y sin marca de agua en varios benchmarks. El índice de inteligencia de Artificial Analysis marca 49,57 puntos sin marca y 49,76 con ella. GPQA Diamond: 94,44 % frente a 93,94 %. BrowseComp: 87,92 % frente a 87,35 %. Las diferencias van en las dos direcciones, que es justo cómo se ve «sin diferencia importante» en la práctica. No te dice cómo quedará tu correo del lunes, pero al menos hay un número donde antes solo había promesas.
Una afirmación que seguro vas a leer: en las pruebas de OpenAI, textGrain igualó o superó a otros métodos, incluido SynthID para texto. Esa es la evaluación de OpenAI mismo. Un día después del anuncio todavía no existía ninguna prueba independiente.
El ejemplo trabajado: una carta de 300 palabras, cuatro escenarios
Los porcentajes se escurren, así que vamos con un documento concreto: una carta de presentación de 300 palabras. Como regla práctica, un token equivale a tres cuartos de palabra, o sea que son unos 400 tokens, justo el tamaño que probó OpenAI.
Escenario A: pegas el borrador de ChatGPT tal cual. En la prueba de OpenAI, un detector reconocería unos 92 de cada 100 pasajes así. Si alguien tuviera un detector (casi nadie lo tiene), la probabilidad de acierto sería alta.
Escenario B: cambias una de cada diez palabras. En 300 palabras son unas 30. La detección baja a unos 66 de cada 100. Trabajaste bien el texto, y aun así es más probable que la señal esté a que no esté.
Escenario C: reescribes una de cada cuatro palabras. Unas 75 palabras. La detección baja a unos 17 de cada 100. Y la verdad, la mayoría de la gente que quiere que «suene a mí» cambia al menos eso.
Escenario D: escribes la carta tú y le pides a ChatGPT solo que corrija tres comas. Aquí las cifras de los titulares ni siquiera se aplican. El modelo te devolvió tu texto con cambios mínimos, así que casi nada salió de sus decisiones aleatorias. El propio Help Center de OpenAI aclara que una marca de agua no indica en qué medida participó un modelo. Puede sugerir que un modelo procesó texto. No muestra quién pensó.
Bueno, ahora la otra cara, que en el mundo hispano pesa mucho porque la desconfianza en los procesos automáticos es alta: el detector está calibrado para marcar mal un texto sin marca más o menos una vez de cada cien. Si una universidad pasara 300 trabajos escritos a mano por un detector así, esperaría unas tres falsas alarmas (el 1 % de 300). Tres estudiantes bajo sospecha por algo que no hicieron. Esa es una de las razones por las que OpenAI no publica el detector «dado el riesgo de marcas no detectadas y de falsos positivos», y la razón por la que un positivo nunca debería valer como prueba.
¿Cuánta gente usa esto? Un par de referencias
Según la encuesta sobre equipamiento y uso de TIC en los hogares del INE (publicada el 20 de noviembre de 2025, con una muestra teórica de 26.862 hogares), el 37,9 % de las personas de 16 a 74 años en España usó alguna herramienta de IA generativa, y entre los de 16 a 24 años la cifra sube al 75,6 %. Son datos de la primera mitad de 2025; hoy el uso seguramente es mayor, pero la escala es clara: esto no es un nicho.
Para América Latina no tengo una cifra comparable de una fuente oficial, y prefiero no inventarla. Lo que sí se vio en X el lunes fue algo bastante claro: varios usuarios latinoamericanos preguntaron si les afecta, y uno cerró un hilo con «¿Crees que esto llegará pronto a Latinoamérica?». Mi lectura, con las limitaciones del caso: OpenAI dice que no es el estándar global y que va a «volver a revisar cada parte de este enfoque», así que no sería raro que la discusión se amplíe más adelante. Pero eso es especulación, no un anuncio.
¿Me afecta? La revisión en seis pasos
No existe un verificador. «¿Está marcado mi texto?» en realidad significa «¿podría estarlo?». Pues así lo averiguas.
Paso 1: ¿dónde se generó el texto?
- Con ChatGPT o Codex, desde una cuenta que usas en la UE: es el grupo que, según OpenAI, recibirá la marca «en las próximas semanas».
- Con ChatGPT desde fuera de la UE (por ejemplo, desde México, Colombia, Argentina, Chile o EE. UU.): OpenAI no anunció ningún despliegue por defecto.
- Con una app o sitio construido sobre la API de OpenAI: solo lleva marca si el desarrollador la activó, y solo en «modelos seleccionados».
- Con Claude, Gemini u otra herramienta: otras reglas. Anthropic marca Claude en todo el mundo en los modelos nuevos compatibles (lo contamos en nuestro artículo sobre Claude y los detectores de IA), y el SynthID de Google ya está en Gemini.
Paso 2: la fecha. OpenAI dice «en las próximas semanas», no «hoy». Un texto escrito antes de que el despliegue llegue a tu cuenta no lleva marca, y OpenAI aclara que el texto anterior a la marca de agua no es detectable.
Paso 3: la longitud. Por debajo de unas 100 a 150 palabras suele haber muy poca señal. Con más de 300 palabras de salida del modelo sin editar, hay de sobra.
Paso 4: ¿cuánto cambiaste? Si más de la cuarta parte de las palabras son tuyas, según OpenAI un detector solo reaccionaría en cerca de uno de cada seis casos. Si solo tocaste la puntuación, prácticamente todo sigue igual.
Paso 5: la pregunta del VPN. En X ya hay quien sugiere pasar por un proxy para evitar la marca. Y la verdad, nada lo confirma. OpenAI no dijo cómo decide quién cuenta como usuario de la UE (¿IP, cuenta, país de facturación?). Las únicas respuestas que circulan son suposiciones, incluida la de un chatbot. No armes un plan encima de eso. Y aunque funcionara, OpenAI dice que va a revisar cada parte del enfoque, y tu universidad o tu empresa no te van a preguntar tu IP de todos modos.
Paso 6: olvídate de los sitios «verificadores». Una página que promete revisar tu texto contra la «marca de ChatGPT» no puede usar el detector de OpenAI. Es un clasificador que adivina, o una página que quiere tus datos. No pegues ahí nada confidencial.
Por qué la UE, y qué exige la ley en realidad
Todo parte de un solo artículo del AI Act. El artículo 50, apartado 2, obliga a los proveedores de sistemas de IA generativa a marcar sus resultados sintéticos (texto, imagen, audio, video) en un formato legible por máquina. Se aplica desde el 2 de agosto de 2026. Hay una excepción para los sistemas que solo hacen «asistencia estándar a la edición» o que no modifican de forma sustancial lo que reciben. Por eso un texto que escribiste tú y solo pasaste a pulir queda en una zona gris.
En España, la autoridad de supervisión de IA es la AESIA, con sede en A Coruña. El reglamento prevé multas de hasta 15 millones de euros o el 3 % de la facturación mundial. Ojo: eso apunta a los proveedores y a las empresas que publican contenido de IA, no a ti cuando usas ChatGPT para tus cosas.
Dos fechas para tener presentes:
- 2 de agosto de 2026: el artículo 50 se aplica. Los sistemas nuevos deberían salir ya con el marcado incluido. Por eso Anthropic activó ese día su marca en Claude.
- 2 de diciembre de 2026: termina una transición de cuatro meses que el paquete «Digital Omnibus» concedió, solo para la obligación de marcado legible por máquina, a los sistemas que ya estaban en el mercado antes del 2 de agosto. Eso explica por qué OpenAI despliega textGrain «en las próximas semanas» y no de un día para otro.
Además hay un código de buenas prácticas sobre transparencia de contenido generado por IA, voluntario, que la Comisión Europea publicó el 10 de junio de 2026. La primera lista de firmantes, del 31 de julio, reunía a unas 190 organizaciones, entre ellas OpenAI, Anthropic, Google, Microsoft, Meta y Mistral. OpenAI escribe en su Help Center que su marca de agua de texto va en línea con sus compromisos en ese código.
Dos cosas que la ley no hace. No exige un letrero visible de «escrito por IA» en cada documento asistido por IA. Y tampoco convierte un positivo de marca de agua en prueba legal de que alguien hizo trampa. Para textos publicados de interés público puede aplicar una obligación de informar, salvo que una persona los haya revisado y alguien asuma la responsabilidad editorial.
textGrain, Claude y Gemini, lado a lado
Los tres grandes asistentes usan ya una variante de la misma idea. Lo que cambia es a quién afecta y quién puede verificar.
| OpenAI (ChatGPT, Codex) | Anthropic (Claude) | Google (Gemini) | |
|---|---|---|---|
| Técnica | textGrain (señal estadística en la elección de palabras) | Variante del SynthID-Text de Google, según Anthropic | SynthID-Text |
| Dónde se aplica | ChatGPT y Codex en la UE, «en las próximas semanas»; API opcional en todo el mundo | Modelos nuevos compatibles, en todo el mundo, desde el 2 de agosto | Ya en uso en Gemini |
| Por defecto u opcional | Por defecto en la UE, apagada por defecto en la API | Por defecto | Por defecto |
| ¿Detector público? | No. Investigadores y organizaciones expertas | Anunciado como próximo | Detector de referencia para desarrolladores |
| Debilidades publicadas | Sí: cifras sobre edición y longitud | Anthropic advierte que un positivo no prueba autoría | Google advierte que reescribir o traducir reduce la confianza |
Así que «OpenAI marca todo» es exagerado. La de Claude es la más amplia. La de OpenAI es la más cautelosa, la más regional, y la única cuyo proveedor publicó, el primer día, cifras de robustez.
¿Burocracia vacía o herramienta útil? Mi lectura
En español en X se oyen dos cosas. De un lado, la ironía: «mucha ceremonia, poca robustez, y el costo lo pagan los pobres ciudadanos europeos», o simplemente «el AI Act en estado puro». Del otro, alguien que nota algo curioso: en Europa el que usa ChatGPT para algo normal lleva la marca, y el que quiere colar un texto la quita en un minuto. Las dos observaciones tienen algo de cierto.
Dónde tiene razón la crítica. Las cifras son sobrias. Quien está decidido a quitarse la marca lo logra reescribiendo, y OpenAI lo dice. Los investigadores también advierten: el grupo de Martin Vechev en la ETH Zúrich mostró, en «Watermark Stealing», que consultando un modelo con marca se pueden reconstruir sus reglas ocultas lo bastante bien como para borrar o falsificar la marca. El éxito promedio superó el 80 %, y costó menos de 50 dólares en los montajes probados. Lo delicado es la falsificación: si alguien puede hacer que un texto ajeno parezca marcado, un positivo deja de ser evidencia segura. Se probó en otros métodos, no en textGrain, pero muestra hacia dónde va el debate.
Dónde se queda corta. Una marca de agua no es un antifraude y nunca se pensó como detector de mentiras. Para los reguladores el objetivo es otro: que plataformas e investigadores puedan detectar grandes volúmenes de texto de máquina sin editar, como spam, redes de bots y producción en masa donde nadie se toma el trabajo de reformular. Para eso basta una señal que acierta el 92 % del tiempo en texto sin tocar.
¿Y la privacidad? Según OpenAI, la marca no vincula el texto con una persona, organización, cuenta, prompt ni conversación, y el detector solo informa si encuentra una marca de OpenAI, sin revelar al usuario ni lo que escribió. Es una declaración del proveedor que no podemos verificar de forma independiente, pero encaja con la técnica: el patrón sale de la elección de palabras y no lleva datos de usuario incrustados. Si pegas datos personales en ChatGPT, tienes un tema de protección de datos que no tiene nada que ver con la marca. De eso trata el curso IA y protección de datos en LATAM.
Qué significa para ti
Siete situaciones, cada una con una recomendación y una primera acción.
Si estudias. Tu texto de ChatGPT puede llevar una marca en las próximas semanas, pero ninguna universidad puede verificarlo hoy, y OpenAI dice que un positivo solo muestra que un modelo procesó el texto. El riesgo no es la marca. El riesgo es entregar texto de IA como trabajo propio donde tu reglamento lo prohíbe. Primera acción: esta semana revisa la política de IA de tu universidad y anota para qué sí puedes usarla. El curso IA para estudiantes universitarios te ayuda con eso.
Si das clases. No puedes usar ese detector, y un positivo no resolvería un caso de todos modos. Lo más sólido es el proceso: tareas que muestren el pensamiento a lo largo del tiempo, borradores, historial de versiones, una conversación sobre el texto. Primera acción: redacta una regla clara sobre IA para tu curso. El curso IA para docentes te muestra cómo.
Si escribes para vivir (redactor, agencia, equipo de contenido). Tus clientes van a preguntar si el texto es de IA. Una marca de agua no responde «¿quién pensó?», y OpenAI mismo lo dice. Al publicar, además, puede entrar en juego el artículo 50, apartado 4. Primera acción: define desde ya cómo vas a explicar el uso de IA (hay una plantilla abajo), en vez de contestar a la defensiva después. Herramientas para eso en el curso Escribir con IA de forma profesional.
Si buscas trabajo. Una carta de presentación que bocetaste con ChatGPT no tiene obligación legal de etiquetarse, ningún reclutador puede revisar textGrain hoy, y un texto que editaste pierde casi toda la señal de todos modos. Lo que de verdad perjudica a las postulaciones es el texto genérico de IA sin retocar. Primera acción: reescribe con tus propias palabras al menos una cuarta parte del borrador, agrega una anécdota concreta que solo tú puedes contar y guarda tu propio borrador. El curso IA para tu CV y búsqueda de empleo muestra un flujo más rápido.
Si eres desarrollador o tienes una app sobre la API de OpenAI. Tienes una opción que el usuario de ChatGPT no tiene. Viene apagada y se activa en los ajustes del proyecto o la organización para los modelos compatibles. Primera acción: decide si tus usuarios necesitan constancia de procedencia (cumplimiento, editoriales, sectores regulados) y prueba la opción en un proyecto de staging antes de prometerle nada a tus clientes.
Si publicas contenido con IA en una pyme o como independiente. Ahí es donde con más facilidad corresponde la obligación de informar, sobre todo con textos de interés público. Primera acción: escribe una frase de responsabilidad editorial en tu proceso (¿quién lo lee antes de publicar?) y revisa el curso Ética y regulación de la IA.
Si estás en América Latina. No estás en el despliegue por defecto, y eso no te vuelve invisible: Claude y Gemini ya marcan texto, y las apps de estudio o de escritura construidas sobre la API pueden activar la opción. Primera acción: guarda borradores con fecha y notas de lo que le pediste a la IA, el mismo hábito que te protege si algún detector se equivoca. Mira también qué hacer si te acusan de usar IA sin haberlo hecho.
Una plantilla: nota de uso de IA
La mejor reacción a las marcas de agua no es pelearse con ellas. Es llevar un registro limpio de cómo usaste la IA, para que el resultado de un detector, sea correcto o no, nunca sea tu única evidencia. Copia esto y adáptalo.
Nota de uso de IA (guárdala junto al archivo final)

Documento: [título]
Fecha: [fecha]
Herramientas usadas: [ChatGPT / Claude / Gemini / ninguna]
Qué hizo la IA: [esquema | corrección gramatical | borrador de las secciones 2 y 4 | traducción | nada]
Qué hice yo: [ideas, estructura, ejemplos, edición final, verificación de datos]
Dónde están los borradores: [historial de versiones de Google Docs / archivo de Word / carpeta]
Fuentes que revisé yo mismo: [lista]
Guárdala en la misma carpeta que tus borradores. Si alguien pregunta, enseñas un registro con fechas en vez de discutir una estadística.
Casos especiales y solución de problemas
Bueno, estas son las preguntas y problemas que aparecieron en las primeras 24 horas.
«¿Me libro con una VPN?» Mira el paso 5: no está confirmado, y no es un buen plan. OpenAI además dice que el enfoque regional es provisional.
«¿Un texto que escribí yo y solo le pedí a ChatGPT que puliera lleva la marca?» Posiblemente en parte. Un modelo que reformula tus frases usa sus propias decisiones de palabras para esas frases. Pero OpenAI dice que un positivo no revela cuánto aportó una persona. Si esa distinción te importa, la nota de uso de IA es la forma de demostrarla.
«¿Copiar a Word o Google Docs borra la marca?» No. La marca está en la elección de palabras, no en caracteres invisibles. El Help Center incluye copiar y pegar entre los cambios que textGrain debe resistir. Reescribir frase por frase con tus palabras sí la debilita, porque reemplazas las decisiones.
«¿Y si traduzco el texto?» OpenAI dice que el texto traducido es más difícil de detectar. No hay cifra. Considera «traducido, entonces sin marca» como probable pero no demostrado, y avisa que usaste ayuda de traducción donde tus reglas lo pidan.
«¿El código de Codex también se marca?» OpenAI dice que el texto de Codex entra. Pero el código deja poco margen de palabras, y la propia gráfica de OpenAI muestra que en contenido poco flexible (como matemáticas) la detección es bastante más débil. En comentarios y documentación la señal debería ser más fuerte que en el código.
«Una página dice que puede revisar mi texto contra la marca de ChatGPT.» No usa el detector de OpenAI. No pegues nada confidencial ahí.
«Un “humanizador” o “removedor” promete quitar la marca.» Algunos quizá la reduzcan, porque reescribir mucho la debilita. Pero no puedes verificar el resultado, y la reescritura puede empeorar tu texto o meterle errores. Si lo que quieres es un texto que suene a ti, editarlo tú a mano es más barato y más seguro.
«Un detector marcó un texto que escribí yo.» Mantén la calma y pide detalles: qué detector, qué umbral, qué longitud, qué otras pruebas hay además del puntaje. Un resultado de marca de agua es un indicio, no un veredicto. Lleva tus borradores y el historial de versiones.
Lo que textGrain no puede hacer
- No prueba que un humano escribió. OpenAI lo dice sin rodeos: que no se detecte una marca no prueba autoría humana. El texto puede ser muy corto, estar editado, traducido, venir de otro proveedor o de antes del despliegue.
- No dice quién pensó. Una marca de agua no mide la parte humana. Alguien que tuvo todas las ideas y pidió corrección gramatical se ve, para un detector, parecido a alguien que pegó un prompt.
- No te identifica. Según OpenAI, no vincula el texto con una persona, cuenta, prompt ni conversación.
- No sobrevive a una edición decidida. Con un cuarto de las palabras cambiadas, la detección de OpenAI cae al 17 %.
- No sirve como prueba en una disputa. Hay falsos positivos (cerca del 1 % en la configuración probada), se han demostrado ataques de falsificación en otros métodos, y el detector todavía no se evaluó de forma independiente.
Lo que sí puede hacer: ayudar a plataformas e investigadores a detectar grandes volúmenes de texto de máquina sin editar, como spam, redes de bots y producción en masa. Eso se parece más a lo que buscan los reguladores que a atrapar una tarea suelta.
Preguntas frecuentes
¿ChatGPT va a marcar ahora todos mis textos? No. OpenAI dice que agregará una marca de agua invisible al texto elegible de ChatGPT y Codex en la UE, en las próximas semanas. No es un ajuste global por defecto. Los clientes de la API en cualquier país pueden activarla en modelos seleccionados, y viene apagada.
¿Qué es textGrain? El método de marca de agua para texto de OpenAI. Inclina las decisiones aleatorias del modelo entre palabras parecidas para que un detector con clave secreta pueda encontrar después un patrón estadístico. No agrega marcas visibles ni caracteres ocultos.
¿Alguien puede comprobar si mi texto tiene la marca? Hoy no. OpenAI da el acceso al detector, al inicio, solo a investigadores y organizaciones expertas aprobados. Los sitios que ofrecen revisar textGrain no usan el detector de OpenAI.
¿La marca revela quién soy o qué escribí en el prompt? Según OpenAI, no. La marca no vincula el texto con una persona, organización, cuenta, prompt ni conversación, y el detector solo informa si encuentra una marca de OpenAI.
¿Puedo desactivarla? El anuncio de OpenAI no describe un ajuste de usuario para ChatGPT en la UE. La empresa dice que, «cuando sea posible», quiere dar opciones. Los clientes de la API pueden activarla en los ajustes del proyecto o la organización. Que «no se pueda apagar» no está ni confirmado ni desmentido en las páginas de OpenAI.
¿Editar el texto quita la marca? La debilita. En la prueba de OpenAI con textos de 400 tokens, la detección bajó de cerca del 92 % a cerca del 66 % al cambiar el 10 % de las palabras, y a cerca del 17 % con el 25 %. Una reescritura fuerte o una traducción pueden dejarla indetectable.
¿Mi profesor o mi empleador me puede descubrir con esto? No con el detector de OpenAI, al que no tienen acceso. Y aunque lo tuvieran, OpenAI dice que un resultado no indica cuánto del texto fue humano, de quién es, ni si se rompió alguna regla.
¿La marca de Claude es distinta? Sí. Anthropic dice que su marca, una variante del SynthID-Text de Google, rige en todo el mundo en los modelos nuevos de Claude compatibles, no solo en la UE. La de OpenAI es regional y su detector es restringido. Más detalles en nuestro artículo sobre Claude y los detectores de IA.
¿Por qué primero la UE? Porque el artículo 50, apartado 2, del AI Act obliga desde el 2 de agosto de 2026 a los proveedores a marcar el texto sintético de forma legible por máquina. Un plazo hasta el 2 de diciembre de 2026 para los sistemas que ya estaban en el mercado explica el despliegue gradual.
¿Debería dejar de usar ChatGPT para escribir? No. El riesgo práctico no es la marca, sino hacer pasar la ayuda de una IA como trabajo propio donde tus reglas lo prohíben. Usa la IA, edita el texto hasta que de verdad sea tuyo, guarda tus borradores y respeta las reglas de tu universidad o tu empresa.
En resumen
textGrain es un cambio real, pero más pequeño y más cauteloso de lo que sugieren los titulares. Los textos de ChatGPT y Codex en la UE recibirán en las próximas semanas una señal estadística invisible. Fuera de la UE no estás en el despliegue por defecto. Aparte de un grupo pequeño de investigadores aprobados, nadie puede verificarla. Y las cifras de OpenAI muestran lo rápido que se desvanece: con un cuarto de las palabras cambiadas, la detección queda en cerca del 17 %.
Entonces, ni pánico ni trucos. Entiende lo que es, sigue las reglas que de verdad te obligan y documenta cómo usaste la IA. Una nota de uso breve y una carpeta de borradores con fecha valen más que cualquier resultado de marca de agua, a tu favor o en tu contra.
Si quieres usar IA con confianza en el trabajo o en la universidad, el curso Ética y regulación de la IA explica las reglas sin jerga legal, IA generativa: fundamentos muestra qué hacen y qué no hacen estas herramientas, y IA y protección de datos en LATAM te ayuda con las dudas de privacidad que no tienen que ver con la marca pero importan igual. Para entender la diferencia entre una marca de agua y un detector de IA, nuestra entrada del glosario What Is an AI Text Watermark? (en inglés) lo resume.
Fuentes
- OpenAI, «Our approach to EU text provenance rules» (5 de octubre de 2026)
- OpenAI Help Center, «Provenance signals in OpenAI-generated content»
- OpenAI, informe técnico de textGrain «Entropy-calibrated watermarking for language model text»
- Hipertextual, «OpenAI pondrá marca de agua a los textos de ChatGPT en Europa»
- La Opinión, «OpenAI pondrá una marca de agua invisible en los textos y códigos creados con IA» (5 de octubre de 2026)
- Teknófilo, «ChatGPT marcará sus textos en Europa: así funciona la huella invisible de OpenAI»
- TechCrunch, «OpenAI will start watermarking ChatGPT’s text in the EU» (5 de octubre de 2026)
- INE, Encuesta sobre equipamiento y uso de TIC en los hogares 2025 (20 de noviembre de 2025)
- AI Act, artículo 50: obligaciones de transparencia
- Consejo de Europa/MERLIN, código de buenas prácticas sobre transparencia del contenido generado por IA
- Cloud Security Alliance, nota sobre el plazo del artículo 50 en diciembre de 2026
- Jovanović, Staab y Vechev (ETH Zúrich), «Watermark Stealing in Large Language Models»
- Google DeepMind, SynthID-Text (Nature)