Am 3. September 2026 verhandelte der Bundesgerichtshof über ein einziges Foto, das 2021 heruntergeladen wurde. Die Frage: War das Verbot, das die Bildagentur ausgesprochen hatte, „maschinenlesbar“? Entschieden hat der Senat an diesem Tag nichts. Dieselbe Frage steht jetzt auf deinem Tisch, falls du eine Website betreibst. Am 30. Oktober 2026 haben sich Google, OpenAI, Microsoft und Anthropic zu einem gemeinsamen Signal für die robots.txt geäußert, mit dem du dem KI-Training widersprechen kannst: Google plant Unterstützung, OpenAI will es beachten, Microsoft will es ab dem 1. Februar 2027 beachten, und bei Anthropic hat die Umsetzung laut Kevin Kelley begonnen.
Die verkürzte Fassung lautet: eine Zeile, vier Konzerne. Wer die Ankündigungen liest, sieht schnell, dass das so nicht stimmt. Und in Deutschland kommt eine juristische Ebene dazu: Ob dein Widerspruch etwas bewirkt, richtet sich nach § 44b des Urheberrechtsgesetzes. Dort ist, Stand 31. Oktober 2026, nicht höchstrichterlich geklärt, was „maschinenlesbar“ heißt. Der BGH-Verkündungstermin im Fall Kneschke ist der 17. Dezember 2026.
Der Beitrag ist für Shop-Betreiber, Fotografinnen, Illustratoren, Blogger, Kursersteller und Selbstständige. Vorweg ein wichtiger Hinweis: Das ist Information, keine Rechtsberatung, und ich bin kein Anwalt. Wo die Rechtslage offen ist, sage ich das. Zu jeder rechtlichen Aussage steht dabei, woher sie stammt.
Was ich gemacht habe: Gesetzestext, BGH-Pressemitteilung, die Ankündigungen der vier Unternehmen und den Entwurf habe ich am 31. Oktober 2026 selbst gelesen, dazu Beiträge von Kanzleien und aus der Wissenschaft. Außerdem habe ich ein kleines Python-Skript auf Beispieldateien laufen lassen. Keinen Crawler habe ich getestet. Eine Suche nach deutschsprachigen Beiträgen auf X zum Thema hat so gut wie nichts ergeben.
Kurz gesagt. Die neue Zeile heißt
User-Agent: __usage_ai-training, darunterDisallow: /. Sie ist freiwillig, bislang nur ein Entwurf, stoppt kein Crawling und regelt keine Rückholung bereits gesammelter Inhalte. EinUser-agent: *gilt nach dem Entwurf nicht als Widerspruch. Anthropic sagt, die Umsetzung habe begonnen, OpenAI nennt „die kommenden Monate“, Google 2027, Microsoft ab dem 1. Februar 2027. Nach § 44b Abs. 3 UrhG muss ein Nutzungsvorbehalt bei online zugänglichen Werken „in maschinenlesbarer Form“ erfolgen. Ob gerade diese Zeile das erfüllt, hat kein Gericht entschieden. Der BGH hat den Fall Kneschke gegen LAION am 3. September 2026 verhandelt, der Verkündungstermin ist der 17. Dezember 2026. Mein Rat: Zeile ergänzen, die Regeln pro Bot behalten, das Datum festhalten und vorher klären, was du überhaupt willst.
Was am 30. Oktober passiert ist
Drei Unternehmen haben auf ihrer eigenen Seite veröffentlicht, das vierte in einer Nachricht an die Standardisierungsgruppe.
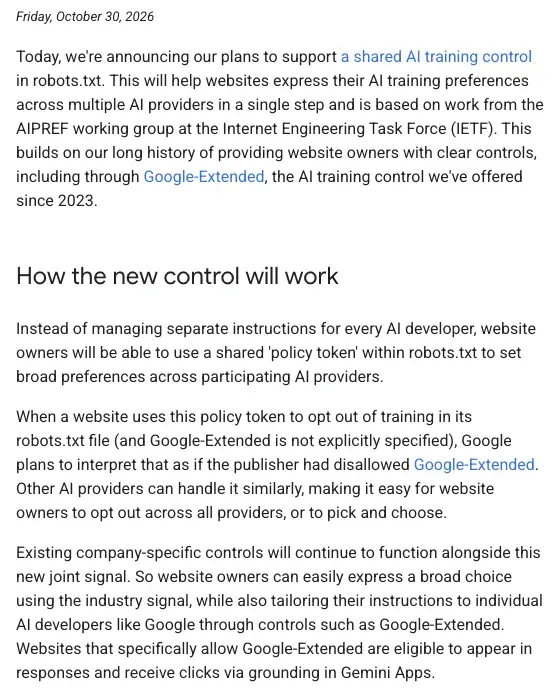
Google schreibt im Search Central Blog (Autor: John Mueller): „Today, we’re announcing our plans to support a shared AI training control in robots.txt.“ Damit sollen Websites ihre KI-Trainingspräferenzen bei mehreren KI-Anbietern in einem einzigen Schritt ausdrücken können (Google: „across multiple AI providers in a single step“), über einen gemeinsamen „policy token“ in der robots.txt. Außerdem schreibt Google: „We aim to support this new control along with other AI providers in 2027, and will provide updates on our progress.“
OpenAI schreibt in der deutschen Fassung: „Heute geben wir bekannt, dass OpenAI ein gemeinsames Signal in der Datei robots.txt beachten wird.“ Es nennt das eine „freiwillige Initiative“. Und: „Wir wollen das Signal in den kommenden Monaten implementieren und werden dann in einem weiteren Update Einzelheiten zur Umsetzung bekannt geben.“ Die bestehenden Crawler-Steuerungen würden nicht ersetzt, sie „gelten weiterhin“.
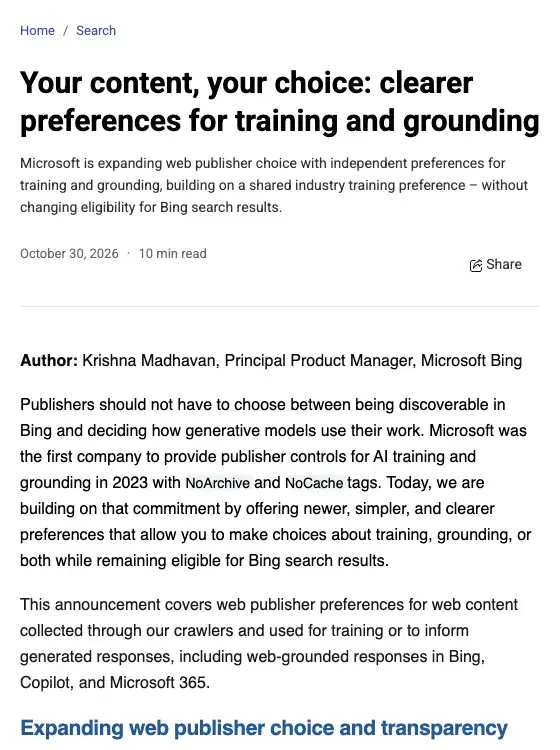
Microsoft (Bing Blog, Autor: Krishna Madhavan) baut laut Untertitel auf „a shared industry training preference“ auf und führt eine eigene, davon unabhängige Einstellung für „Grounding“ ein. Ab dem 1. Februar 2027 will Microsoft die neuen Präferenzen beim Crawlen berücksichtigen.
Bei Anthropic gibt es keinen Blogbeitrag, sondern eine Nachricht. Kevin Kelley, im Kopf des Entwurfs als „K. Kelley, Anthropic“ genannt, schrieb am 30. Oktober an die IETF-Mailingliste: „I’m also excited to share that Anthropic has already started implementing support for this draft.“ Dazu: „It’ll take us some time to add support across our services“. Die Nachricht, die ich ganz gelesen habe, nennt kein konkretes Datum für Anthropics Umsetzung, und der Name ClaudeBot kommt darin nicht vor. Ob ClaudeBot die Zeile heute schon liest, kann ich dir nicht sagen.
| Anbieter | Was gesagt wurde | Zeitangabe |
|---|---|---|
| Anthropic | Umsetzung „already started“ | Kein konkretes Datum |
| OpenAI | Wird das Signal beachten | „In den kommenden Monaten“ |
| Microsoft | Beachtet die Präferenzen beim Crawlen | Ab 1. Februar 2027 |
| Plant Unterstützung | 2027 |
Auf Googles Crawler-Seite steht „in early 2027“. Keiner der vier sagt: „Wir lesen das ab heute.“ Eine Zeile, die du heute einfügst, ist also zunächst eine Erklärung an die Zukunft.
Die Zeile selbst: Was im Entwurf steht
Der Entwurf heißt „Machine-Readable Training Preference Signal“ (draft-kelley-aipref-training-preference-signal-00), ist auf den 30. Oktober 2026 datiert und läuft am 3. Mai 2027 ab. Er ist ein Internet-Draft, also Arbeitsstand: Der Text selbst hält es für „inappropriate“, Internet-Drafts anders als als „work in progress“ zu zitieren. Der angestrebte Status „Standards Track“ beschreibt, wohin er will, nicht, wo er steht.
Sein Beispiel (Figure 1) hat drei Zeilen:
User-Agent: __usage_ai-training
Disallow: /
Allow: /presse/
(Im Entwurf heißt der Ausnahmepfad /press-kit/; ich habe ihn eingedeutscht.) Das heißt: kein Training mit meinen Seiten, außer mit dem Pressebereich. Der Entwurf definiert KI-Training als „Using an asset to modify the learned parameters of a generative AI model“. Modelle, die ausschließlich nicht-generative Aufgaben erledigen, zählt er nicht dazu. Neue Direktiven oder eine neue Grammatik führt er laut Abstract nicht ein („no new directive names and no new grammar“): Es ist die robots.txt, die du kennst, nur mit einem Namen in der User-Agent-Zeile, der kein echter Crawler ist.
Fünf Regeln daraus sind für dich wichtig:
- Der Name muss exakt stimmen. Zwei Unterstriche,
usage, Unterstrich,ai, Bindestrich,training. Nur Groß- und Kleinschreibung ist egal. Wer sich vertippt, schreibt einen anderen Namen und sagt damit nichts. - Ein Platzhalter zählt nicht. Abschnitt 4.2: „wildcard groups (i.e., User-Agent: *) MUST NOT be interpreted as matching the policy token.“ Dein
User-agent: *ist also kein Widerspruch gegen KI-Training. - Ohne Token-Gruppe gibt es keine Äußerung. Der Entwurf schreibt: „no preference has been expressed“. Wo keine Gruppe das Token enthält, hat der Betreiber also nach dem Entwurf keine Präferenz ausgedrückt.
- Es wirkt pfadweise.
Disallow: /meint die ganze Website,Disallow: /portfolio/einen Bereich,Allow:schafft Ausnahmen. - Es ist keine Crawling-Regel. Abschnitt 4.4: „This policy token is not a directive for crawling behavior.“ Deine Regeln für einzelne Bots gelten unverändert, beides ist laut Entwurf „independent and orthogonal“.
Abschnitt 4.5 sagt noch: „Private agreements MAY override preferences expressed via this mechanism.“ Ein Lizenzvertrag kann die Präferenz also aushebeln. Das betrifft dich, wenn du Bilder oder Texte an Agenturen, Verlage oder Plattformen lizenzierst.
Ein Test mit drei Beispieldateien
Die Platzhalter-Regel ist die Stelle, an der ich die meisten Fehler erwarte, deshalb habe ich sie ausprobiert. Am 31. Oktober 2026 habe ich den Standard-Parser urllib.robotparser von Python 3.14.6 auf drei Beispieldateien laufen lassen und gefragt, ob drei Namen den Pfad /portfolio/ abrufen dürfen. Das sind meine eigenen Muster, keine echte Website.
# Datei A
User-agent: *
Disallow: /intern/

# Datei B
User-agent: *
Disallow: /

User-agent: Googlebot
Allow: /

# Datei C
User-agent: __usage_ai-training
Disallow: /
Allow: /presse/
| Datei | Token | GPTBot | Googlebot |
|---|---|---|---|
| A: Platzhalter sperrt nur /intern/ | darf | darf | darf |
| B: Platzhalter sperrt alles | darf nicht | darf nicht | darf |
| C: nur die Token-Gruppe | darf nicht | darf | darf |
Schau auf die mittlere Zeile. In Datei B antwortet der Python-Parser für den Token-Namen „darf nicht“, weil er die Platzhalter-Gruppe auf jeden Namen anwendet. Der Entwurf verlangt das Gegenteil. Nach dem Entwurf hat Datei B also gar keinen Trainingswiderspruch ausgedrückt, obwohl sie jeden folgsamen Crawler aussperrt. Nur Datei C macht, was die Zeile soll, und lässt GPTBot in Ruhe, weil keine Regel ihn nennt.
Wer „alles“ per Platzhalter gesperrt hat, hat dem Training damit nicht widersprochen. Und wer mit der neuen Zeile widerspricht, hat damit allein noch keinen Crawler gesperrt.
Der deutsche Rahmen: § 44b UrhG in drei Absätzen
Das Gesetz erlaubt in § 44b unter Bedingungen das automatisierte Auswerten von Werken, „Text und Data Mining“. Den Wortlaut habe ich auf gesetze-im-internet.de gelesen:
- Absatz 1 definiert Text und Data Mining als „die automatisierte Analyse von einzelnen oder mehreren digitalen oder digitalisierten Werken, um daraus Informationen insbesondere über Muster, Trends und Korrelationen zu gewinnen“.
- Absatz 2 erlaubt Vervielfältigungen von rechtmäßig zugänglichen Werken für dieses Mining. Die Kopien sind zu löschen, wenn sie dafür nicht mehr erforderlich sind.
- Absatz 3 ist für dich der Kern: „Nutzungen nach Absatz 2 Satz 1 sind nur zulässig, wenn der Rechtsinhaber sich diese nicht vorbehalten hat. Ein Nutzungsvorbehalt bei online zugänglichen Werken ist nur dann wirksam, wenn er in maschinenlesbarer Form erfolgt.“
Das Gegenstück auf EU-Ebene ist Art. 4 Abs. 3 der Richtlinie 2019/790. Danach gilt die Ausnahme, sofern der Rechteinhaber nicht „ausdrücklich in angemessener Weise, etwa mit maschinenlesbaren Mitteln im Fall von online veröffentlichten Inhalten“ einen Vorbehalt erklärt hat. Erwägungsgrund 18 sagt dazu, bei online veröffentlichten Inhalten sei ein Vorbehalt „mit maschinenlesbaren Mitteln“ angemessen, und fügt an: „Das gilt auch für Metadaten und Geschäftsbedingungen einer Website oder eines Dienstes.“ Geschäftsbedingungen sind damit als möglicher Ort genannt. Wann ein Text darin „maschinenlesbar“ ist, beantwortet das nicht.
Das Gesetz definiert „maschinenlesbar“ nämlich nicht. Der Berufsverband Freie Fotografen und Filmgestalter (BFF) schreibt am 9. September 2026, das Gesetz verlange einen maschinenlesbaren Vorbehalt, definiere den Begriff aber nicht, und kein Gericht habe ihn bisher konkretisiert. Der BFF ist eine Interessenvertretung. Dass der Begriff im Gesetzestext fehlt, sehe ich aber selbst.
Drei Einordnungen gehen in der Debatte oft unter.
Gegen Forschung hilft der Vorbehalt nicht. § 60d UrhG, die Schranke für Text und Data Mining zu Forschungszwecken, verweist laut Gesetzestext auf § 44b Absatz 1 und Absatz 2 Satz 1, nicht auf Absatz 3. Prof. Dr. Michael Beurskens (Universität Passau) schreibt in seinem Merkblatt zu KI-Crawlern dasselbe: Die wissenschaftliche Auswertung lasse sich nicht verhindern. Als Forschungsorganisation gilt nach § 60d Abs. 2 nicht, wer mit einem privaten Unternehmen zusammenarbeitet, das maßgeblichen Einfluss und bevorzugten Zugang zu den Ergebnissen hat.
Der Vorbehalt betrifft nur geschützte Werke. Beurskens weist darauf hin, dass die Auswertung nur bei urheberrechtlich geschützten Inhalten ausgeschlossen ist. Maschinengeneriertes, Werke von lange Verstorbenen oder Inhalte ohne ausreichende Schöpfungshöhe fallen nicht darunter. Ein Datenblatt mit Maßen und Artikelnummern ist vermutlich etwas anderes als das Foto, das du selbst komponiert hast. Was geschützt ist, entscheidet im Zweifel ein Gericht.
Offene Lizenzen machen den Vorbehalt egal. Auch das steht bei Beurskens: Inhalte unter CC0, CC-BY oder CC-BY-SA können zum Training benutzt werden, dann spielt der Rechtevorbehalt keine Rolle.
Was die Gerichte bisher gesagt haben
Hier muss man genau sein, denn in der Debatte wird viel verkürzt. Die Entscheidungen, die ich zu der Frage gefunden habe, stammen alle aus einem Verfahren.
Kneschke gegen LAION
Der Sachverhalt laut BGH-Pressemitteilung Nr. 085/2026 vom 20. Mai 2026: Ein Fotograf klagt gegen einen gemeinnützigen Verein, der einen Datensatz mit 5,85 Milliarden Bild-Text-Paaren bereitstellt. Der Datensatz enthält Bild-URLs und Beschreibungen, nicht die Bilder. Der Verein lud Bilder herunter und prüfte per Software, ob Beschreibung und Bildinhalt zusammenpassen. Im zweiten Halbjahr 2021 wurde so auch das Vorschaubild einer Fotografie des Klägers heruntergeladen. Die Bildagentur, auf deren Seite es stand, hatte automatisierte Zugriffe untersagt.
Landgericht Hamburg, 27. September 2024 (310 O 227/23). Die Klage wurde abgewiesen, gestützt auf die Forschungsschranke des § 60d UrhG (so die Pressemeldungen der Kanzlei Heidrich). Zu § 44b äußerte sich das Gericht nur nebenbei. Laut einem Gastbeitrag von Dr. Saskia Ostendorff bei Legal Tribune Online hielt es einen Vorbehalt in natürlicher Sprache für ausreichend, weil KI-Anwendungen natürliche Sprache verstehen können. Das war nicht tragend. Ostendorff schreibt: „Im Ergebnis kam es aber auf die Schrankenregelung des § 44b UrhG im Fall Kneschke nicht an.“
Oberlandesgericht Hamburg, 10. Dezember 2025 (5 U 104/24). Die Berufung wurde zurückgewiesen. Nach der BGH-Pressemitteilung bejahte das OLG eine Vervielfältigung, hielt sie aber durch § 44b und § 60d für gedeckt. Der Nutzungsvorbehalt der Bildagentur sei unwirksam, weil der Kläger nicht dargelegt habe, dass er maschinenlesbar war. Die Revision wurde zugelassen, das Urteil ist nicht rechtskräftig.
Zur Begründung gibt es verschiedene Darstellungen. Den Volltext habe ich nicht abrufen können, das Hamburger Rechtsportal lieferte mir nur die Suchmaske. In einem Beitrag von Jan Ehlers heißt es, ein menschenlesbarer Hinweis in den AGB der Agentur und im Quellcode habe nicht gereicht, und der Kläger habe nicht dargelegt, dass er im maßgeblichen Zeitraum (zweite Jahreshälfte 2021) von Maschinen interpretierbar war. Die Initiative Urheberrecht, eine Interessenvertretung von Rechteinhabern, gibt einen Kommentar der VG Bild-Kunst wieder, die den Kläger unterstützt: Das OLG habe natürliche Sprache im Jahr 2021 nicht für eine „maschinenlesbare Form“ gehalten und offengelassen, ob sie es heute ist. Dieser Kommentar ist nicht neutral.
Sicher ist nur, was in der Pressemitteilung des BGH selbst steht: Das OLG stellte darauf ab, dass die Maschinenlesbarkeit nicht dargelegt war, und ließ die Revision zu. Wichtig ist auch, was ich nicht gefunden habe: Es ging um einen Fall von 2021 mit einem Verbot in den Bedingungen der Agentur. Nach der Pressemitteilung und den Kommentaren, die ich gelesen habe, ging es um natürliche Sprache, nicht um eine robots.txt-Zeile, und das neue Token existierte noch nicht. Wer behauptet, das OLG habe robots.txt „anerkannt“ oder „abgelehnt“, sollte das am Volltext belegen, den ich nicht gelesen habe.
Bundesgerichtshof, I ZR 281/25. Verhandelt wurde am 3. September 2026, Beginn 9:00 Uhr, entschieden nichts. Laut der Pressemeldung der Kanzlei Heidrich nach der Verhandlung äußerte der Senat eine vorläufige Rechtsauffassung: Die Tatbestände des Text und Data Mining griffen im Grundsatz ein. Zu § 44b Abs. 3 habe der Senat Fragen aufgeworfen, nämlich ob eine Formulierung in natürlicher Sprache genügt und ob Maschinenlesbarkeit auch Maschinenverständlichkeit voraussetzt, ohne eine abschließende Meinung zu äußern. Eine Vorlage einzelner Auslegungsfragen an den EuGH komme in Betracht, sei aber nicht beschlossen. Die Seite sagt nicht, welche Rolle die Kanzlei im Verfahren hat. Ich gebe das deshalb als Bericht einer Kanzleiseite wieder, nicht als Wortlaut des Gerichts.
Die BGH-Terminübersicht nennt als Verkündungstermin den 17. Dezember 2026, 8:45 Uhr. Was dann verkündet wird, wusste am 31. Oktober 2026 niemand. Nach den Berichten ist ein Urteil denkbar und ebenso eine Vorlage an den EuGH. Ich lege mich nicht fest.
Was aus München dazukommt
Am 11. November 2025 entschied das Landgericht München I im Fall GEMA gegen OpenAI (42 O 14139/24). Es ging um neun Liedtexte, die in den Modellen reproduzierbar gespeichert waren. Laut Pressemitteilung des Gerichts greift § 44b nur bei vorbereitenden Kopien für die Datenauswertung. Werde ein Werk im Modell vervielfältigt, liege „kein Text und Data Mining“ vor. Auch die Wiedergabe der Texte im Chatbot sah das Gericht als Verletzung. Das Urteil ist laut Pressemitteilung nicht rechtskräftig, den heutigen Stand der Berufung habe ich nicht prüfen können.
Für deine robots.txt heißt das: Das Urteil sagt nichts über die Wirksamkeit eines Vorbehalts. Es betrifft eine andere Stufe, nämlich ob ein Modell geschützte Texte behalten und ausgeben darf. Von Liedtexten lässt sich nicht einfach auf Fotos oder Produktseiten schließen.
EuGH und EU-Seite
Beim EuGH ist laut InfoCuria am 31. Oktober 2026 die Rechtssache C-250/25 (Like Company) anhängig, ein Vorabentscheidungsersuchen vom 3. April 2025. Nach Berichten, die ich nicht im Wortlaut geprüft habe, geht es um Chatbots, das Presseverlegerrecht und die Ausnahme für Text und Data Mining. Einen Termin nenne ich nicht, weil sich die Quellen dazu widersprechen.
Für die Anbieter gilt: Der AI Act verpflichtet Anbieter von KI-Modellen mit allgemeinem Verwendungszweck ab dem 2. August 2025, eine Strategie zur Einhaltung von Vorbehalten zu haben (so beschreibt es die Kanzlei Lausen, Art. 53 Abs. 1 lit. c). Der Verhaltenskodex verlangt laut Legal Tribune Online (1. August 2025), beim Crawlen die robots.txt zu beachten und weitere maschinenlesbare Signale zu berücksichtigen. Die EU-Kommission hat am 1. Dezember 2025 eine Konsultation zu maschinenlesbaren Opt-out-Protokollen gestartet (Frist: 23. Januar 2026) und will danach eine Liste allgemein vereinbarter Lösungen veröffentlichen. Auf der Seite (zuletzt aktualisiert am 16. Dezember 2025, von mir gelesen am 31. Oktober 2026) steht kein Ergebnis.
Was daraus für deine robots.txt folgt
Ich ziehe daraus fünf Schlüsse. Das ist meine Lesart der Quellen, keine Rechtsauskunft.
Erstens: Die Zeile ist ein Baustein, kein Beweis. Eine Entscheidung, ob eine robots.txt-Zeile ein wirksamer Vorbehalt nach § 44b Abs. 3 ist, habe ich nicht gefunden. Mehrere Kanzleien und Wissenschaftler nennen sie als Beispiel für „maschinenlesbar“: Beurskens als Variante 1, Lausen als „weit etablierten Ansatz“, die IT-Recht Kanzlei in einem Beispiel. Die IT-Recht Kanzlei sagt dabei aber nichts dazu, ob eine robots.txt rechtlich wirksam ist. Sie gilt als naheliegende Form, nicht als geklärte.
Zweitens: Das Token spart dir Arbeit. Lausen beschreibt als Nachteil der robots.txt, dass du alle relevanten KI-Bots kennen und einzeln nennen musst. Genau das soll das Token ersparen. Ob ein Gericht ein Token, das noch kein Standard ist, als wirksamen Vorbehalt anerkennt, weiß niemand.
Drittens: Der Zeitpunkt zählt. Das OLG stellte nach der BGH-Pressemitteilung darauf ab, ob der Vorbehalt maschinenlesbar war, und nach Ehlers auf den Zeitraum 2021. Nach Abschnitt 3 des Entwurfs sind die Präferenzen für einen Inhalt die, die in der robots.txt standen, als er abgerufen wurde. Meine Überlegung daraus: Halte fest, wann du die Zeile eingefügt hast (Versionsverwaltung, Screenshot mit Datum). Du kannst später zeigen, was wann auf deiner Seite stand.
Viertens: Kombiniere. Die IT-Recht Kanzlei empfiehlt am 14. November 2025 einen Vorbehalt, der für Menschen lesbar und maschinenlesbar ist, und nennt unter anderem das Impressum. Beurskens beschreibt als zweite Variante das TDMRep-Protokoll mit <meta name="tdm-reservation" content="1">, merkt aber an, dass es 2024 nur ein Vorschlag war und nicht überall automatisch erkannt wurde. Für Bilder, Musik und Videos nennt Lausen Metadaten an der Datei, weil ein Vorbehalt auf deiner Website verloren geht, sobald die Datei woanders genutzt wird.
Fünftens: Behalte deine Regeln pro Bot. Das sind heute die einzigen Signale, die sicher in Kraft sind. OpenAI und Google sagen ausdrücklich, dass ihre bestehenden Steuerungen weiter gelten.
Training, Grounding und Suche sind drei verschiedene Dinge
Wenn Leute sagen „ich will KI blocken“, meinen sie meistens drei Dinge auf einmal.
- Training: Das Unternehmen nutzt deine Seiten, um die gelernten Parameter eines generativen Modells zu verändern. So definiert es der Entwurf.
- Suche oder Abruf: Ein Bot ruft deine Seiten ab oder indexiert sie, damit eine Suchfunktion sie anzeigen oder verlinken kann.
- Grounding: Das System schlägt deine Seite im Moment einer Antwort nach und benutzt sie, um die Antwort zu schreiben. Microsoft: „Grounding connects generated responses to web content when an answer is created“.
Die gemeinsame Zeile spricht nur über das Erste. Was die Unternehmen auf ihren eigenen Seiten zum Rest sagen:
| Anbieter | Training | Suche und Antworten | Folge einer Trainingssperre |
|---|---|---|---|
| OpenAI | GPTBot | OAI-SearchBot | Keine, Einstellungen unabhängig |
| Anthropic | ClaudeBot | Claude-SearchBot, Claude-User | Nicht erklärt |
| Microsoft | Gemeinsame Zeile ab 1. Feb 2027 | Grounding pro Seite | Getrennt einstellbar |
| Google-Extended | Googlebot (Suche) | Gekoppelt an Gemini-Antworten |
Bei OpenAI ist die Dokumentation am klarsten: „Each setting is independent of the others.“ Du kannst OAI-SearchBot erlauben und GPTBot sperren. Wer OAI-SearchBot sperrt, taucht laut OpenAI in ChatGPT-Suchantworten nicht auf, kann aber als Link erscheinen. ChatGPT-User, der Bot für Abrufe auf Wunsch einer Person, wird von robots.txt laut OpenAI möglicherweise gar nicht erfasst. Erlaubst du GPTBot und OAI-SearchBot, kann OpenAI die Ergebnisse eines einzigen Abrufs für beide Zwecke nutzen.
Anthropic trennt nach seiner Hilfeseite (Stand 7. April 2026) ebenfalls drei Bots: ClaudeBot sammelt Inhalte, die zum Training beitragen können. Wer Claude-User deaktiviert, kann in der nutzergesteuerten Websuche weniger sichtbar sein. Claude-SearchBot dient der Qualität von Suchantworten. Die neue Zeile erwähnt die Seite nicht.
Google: der Haken
Google-Extended ist kein Crawler, sondern ein „standalone product token“ ohne eigenen User-Agent. Es steuert, ob Inhalte für das Training künftiger Gemini-Modelle genutzt werden dürfen. Es beeinflusst laut Googles Crawler-Seite die Aufnahme in die Google-Suche nicht und ist kein Ranking-Signal.
Jetzt lege das neben Muellers Beitrag. Wenn du mit dem neuen Token dem Training widersprichst und Google-Extended nicht ausdrücklich nennst, will Google das behandeln, „as if the publisher had disallowed Google-Extended“. Und: „Websites that specifically allow Google-Extended are eligible to appear in responses and receive clicks via grounding in Gemini Apps.“
Der Schluss daraus ist meiner, nicht Googles: Bei Google hängen „trainiere nicht mit mir“ und „zeige mich in Gemini-Antworten“ am selben Schalter. Wer sichtbar bleiben will, lässt Google-Extended ausdrücklich zu und akzeptiert das Training bei Google. Wer es sperrt, verzichtet auf beides. Wie groß der Effekt auf Klicks ist, kann ich nicht beziffern, ich habe keine unabhängige Messung gefunden.
Dazu kommt eine juristische Folge, die ich bei der Entscheidung nicht übersehen würde: Wer Google-Extended ausdrücklich erlaubt, erklärt gegenüber Google das Gegenteil eines Vorbehalts. Das ist eine bewusste Entscheidung für Gemini-Sichtbarkeit und gegen den Vorbehalt bei diesem einen Anbieter. Bei Fotos oder Kursmaterial, von denen du lebst, würde ich das sehr genau abwägen.
Microsoft trennt beides
Bei Microsoft gibt es zwei unabhängige Einstellungen. AI Training setzt du in der robots.txt für die Website oder einen Pfad oder per Meta-Tag pro Seite; die Seiten-Einstellung überschreibt die robots.txt. AI Grounding gibt es nur pro Seite, mit den Werten Allow, DisallowExtended und Disallow. Microsoft schreibt: „Both default to Allow when no applicable preference is published.“ Ohne veröffentlichte Präferenz gilt also Allow. Für klassische Bing-Ergebnisse ändern beide nichts.
Microsofts Beispiel: Training auf Disallow, Grounding auf Allow, „to keep content eligible to inform generated responses without allowing it to train generative models“. Dazu die Warnung: „If you select DisallowExtended or Disallow for grounding, you will see reduced brand visibility in AI experiences.“ Wer NoArchive oder NoCache einsetzt, hat einen Stichtag: Nach dem 1. März 2027 werden die beiden Tags nicht mehr als Präferenz gelesen.
So entscheidest du in vier Fragen
Frage 1: Ist der Inhalt selbst dein Produkt? Ein Foto, eine Illustration, der Text deines bezahlten Kurses: Hier greift ein Training in das ein, wovon du lebst, und die Zeile lohnt sich auch bei ungeklärter Wirkung. Bei Öffnungszeiten, Speisekarte und Kontaktformular gibt es wenig zu schützen und viel zu gewinnen, wenn man dich findet.
Frage 2: Liegt der Inhalt bei dir oder bei Dritten? Eine Zeile in deiner robots.txt wirkt nur für das, was unter deiner Domain liegt. Bilder auf Instagram, bei einer Stock-Agentur oder auf Etsy unterliegen den Regeln der Plattform. Lausen weist darauf hin, dass der ortsbezogene Vorbehalt verloren geht, sobald Inhalte außerhalb der Website genutzt werden. Wenn du über Dritte vertreibst, lohnt sich ein Blick in deren Bedingungen und in deine Verträge.
Frage 3: Willst du in Gemini-Antworten auftauchen? Das ist die Google-Frage von oben. Frag Gemini, ChatGPT und Copilot, was deine Kunden fragen würden, und schau, ob du genannt wirst. Wenn ja, sind die Such- und Antwort-Bots deine Freunde. Wenn du dort nie auftauchst, verlierst du durch eine Sperre wenig, und die größere Aufgabe ist, überhaupt genannt zu werden.
Frage 4: Schreib es auf, behalte das Alte, setz dir einen Termin. Der 17. Dezember 2026 und der 1. Februar 2027 sind gute Daten für einen zweiten Blick.
| Du bist… | Training | Such- und Antwort-Bots | Dazu |
|---|---|---|---|
| Fotograf oder Illustratorin | Widersprechen | Meist erlauben | Metadaten in den Dateien |
| Kursersteller mit Bezahlinhalten | Widersprechen | Verkaufsseiten erlauben | Bezahlinhalte hinter Login |
| Shop-Betreiber | Je nach Inhalt | Erlauben | Texte und Fotos trennen |
| Blogger | Wertefrage | Meist erlauben | Antworten verlinken zurück |
| Seite mit Mandantendaten | Privat halten | Privat halten | Ein Vorbehalt ist kein Schutz |
Nichts davon ist eine Regel. Die Seiten der Anbieter erklären, wie die Schalter funktionieren, nicht, was für dein Geschäft richtig ist. Die letzte Zeile halte ich für die wichtigste: Was nicht gelesen werden darf, gehört hinter ein Login. Beurskens sagt es ähnlich, und auch Squarespace schreibt in seinem Hilfeartikel, robots.txt sei „only a request“. Wer Inhalte von Crawlern fernhalten wolle, müsse sie privat stellen.
Ein Beispiel: Fotografin Mara aus Leipzig
Zur Veranschaulichung habe ich mir eine Person ausgedacht. Mara betreibt ein kleines Fotostudio mit Portfolio und Print-Shop. Alles folgende ist ein erfundenes Beispiel für den Ablauf, kein echter Fall.
Schritt 1: lesen, was da ist. Mara öffnet meine-domain.de/robots.txt. Bei ihr steht eine Gruppe: User-agent: * mit Disallow: /intern/. Das ist unsere Datei A und sagt zum Training nichts.
Schritt 2: die Fragen beantworten. Das Portfolio ist ihr Produkt. Die Bilder liegen auf ihrer Domain, außerdem bei Instagram und einer Agentur. Sie testet drei Fragen nach „Fotografin Leipzig Hochzeit“ in verschiedenen Assistenten, und in einer Antwort wird sie genannt.
Schritt 3: entscheiden. Sie will in der ChatGPT-Suche auftauchen, also bleibt OAI-SearchBot erlaubt. Dem Training widerspricht sie, auch bei Google, und nimmt in Kauf, dass sie in Gemini-Antworten seltener erscheint.
Schritt 4: schreiben. Sie behält ihre Gruppe und fügt hinzu:
User-agent: *
Disallow: /intern/

User-agent: __usage_ai-training
Disallow: /

User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /
Die erste Gruppe war schon da, die zweite ist die gemeinsame Zeile. Die Zeilen für GPTBot und ClaudeBot gibt es schon heute, damit der Widerspruch nicht auf die Umsetzung der gemeinsamen Zeile warten muss. Die letzte sperrt Google-Extended ausdrücklich.
Hätte Mara sich für Gemini-Sichtbarkeit entschieden, stünde am Ende User-agent: Google-Extended mit Allow: /. Auch diese Variante habe ich geprüft: Mit dem Python-Parser vom 31. Oktober 2026 dürfen bei ihr für /portfolio/ das Token, GPTBot und ClaudeBot nicht, OAI-SearchBot, Googlebot und Google-Extended dürfen. Das ist, was sie wollte. Nur hätte sie damit Google ausdrücklich erlaubt, ihr Portfolio fürs Gemini-Training zu nutzen. Die Entscheidung trifft sie, nicht der Parser.
Schritt 5: prüfen, dokumentieren, warten. Mara lädt ihre robots.txt neu, prüft den Namen auf den Buchstaben und macht einen Screenshot mit Datum. Den 17. Dezember 2026 und den 1. Februar 2027 trägt sie in den Kalender ein. Für Bilder auf fremden Plattformen liest sie die Bedingungen.
Was sie bekommt, sind Erklärungen, keine Garantie. Was sie behält, ist ihre Sichtbarkeit in der Suche.
Randfälle und Fehlersuche
„Ich habe alles mit User-agent: * gesperrt, also bin ich fein.“ Nach dem Entwurf hast du dem Training nicht widersprochen, und du sperrst obendrein Suchmaschinen aus. Das zeigt Datei B. Beurskens warnt, dass Disallow: / für alle auch Google und Bing betrifft, und rät, gezielt einzelne Crawler auszuschließen.
„Ich habe die Zeile geschrieben und nichts ist passiert.“ Zu erwarten, siehe oben. Behalte deine Zeilen pro Bot.
„Mein Shop-System lässt mich die robots.txt nicht ändern.“ Was Shopify, Wix, WordPress, JTL oder Shopware zur neuen Zeile anbieten, habe ich nicht geprüft. Schau in die Hilfe deines Systems und auf das Datum des Artikels. Eine Hilfeseite von vor Oktober 2026 kennt das Token nicht. Squarespaces Hilfeartikel, zuletzt am 8. Januar 2026 aktualisiert, beschreibt ein Kästchen „Block known artificial intelligence crawlers“, das Regeln für namentlich bekannte KI-Crawler einträgt (darunter GPTBot, ClaudeBot und Google-Extended) und standardmäßig nicht angehakt ist. Von der neuen Zeile steht dort nichts.
„Ich habe Google-Extended gesperrt, und Gemini nennt mich nicht mehr.“ Google koppelt Google-Extended an das Grounding in den Gemini Apps. Wenn dir die Nennung wichtig ist, erlaube es ausdrücklich.
„Was ist mit personenbezogenen Daten?“ Dieser Beitrag behandelt das Urheberrecht. Die DSGVO ist ein eigenes Thema, und eine robots.txt-Zeile ändert daran nichts.
Was das nicht kann
- Es holt Gesammeltes nicht zurück. Nach Abschnitt 3 des Entwurfs zählt die robots.txt, die beim Abruf galt. Von einer Entfernung bereits gesammelter Inhalte steht im Entwurf nichts; das ist meine Lesart, kein Zitat.
- Es erzwingt nichts. OpenAI nennt die Initiative selbst „freiwillig“. Die rechtliche Wirkung kommt, wenn überhaupt, aus § 44b, nicht aus der Zeile.
- Es zahlt dir nichts. Microsoft sagt, die Präferenzen „do not establish licensing or payment arrangements“.
- Es versteckt keine Seiten und hilft nicht gegen Forschung. Das Token ist kein Crawling-Befehl, und § 60d verweist nicht auf § 44b Abs. 3. Was privat bleiben muss, gehört hinter ein Login.
- Es bleibt nicht unbedingt, wie es ist. Der Entwurf läuft am 3. Mai 2027 ab, wenn er nicht überarbeitet wird. Namen, Regeln und Termine können sich ändern.
FAQ
Ist eine robots.txt-Zeile in Deutschland ein wirksamer Nutzungsvorbehalt? Das ist ungeklärt. Mehrere Kanzleien und die Wissenschaft nennen robots.txt als Beispiel für eine maschinenlesbare Form. Eine Entscheidung, die eine robots.txt-Zeile oder das neue Token als wirksam oder unwirksam bewertet, habe ich nicht gefunden. Der BGH hat die Frage nach der Maschinenlesbarkeit am 3. September 2026 aufgeworfen und bis zum 31. Oktober 2026 nicht beantwortet.
Reicht ein Satz in Impressum oder AGB? Erwägungsgrund 18 nennt Geschäftsbedingungen als möglichen Ort. Das OLG Hamburg hielt den Vorbehalt in natürlicher Sprache im Fall Kneschke aber nicht für dargelegt maschinenlesbar, das LG Hamburg sah es nebenbei anders, und der BGH hat Fragen dazu. Ein zusätzlicher lesbarer Satz schadet nicht. Allein darauf verlassen würde ich mich nicht.
Bin ich als Shop-Betreiber überhaupt „Rechtsinhaber“? Nur für Inhalte, an denen du die Rechte hältst und die urheberrechtlich geschützt sind. Bei Herstellertexten oder Fotos von Lieferanten ist das eher deren Frage. Beurskens betont, dass der Vorbehalt nur geschützte Inhalte betrifft.
Muss ich heute etwas tun? Nein. Wenn du dem Training widersprechen willst, musst du aber nicht auf das Token warten: Die Zeilen pro Bot wie GPTBot, ClaudeBot und Google-Extended sind heute in Kraft. Wer bei Bing NoArchive oder NoCache nutzt, hat bis zum 1. März 2027.
Was passiert am 17. Dezember 2026? Der BGH hat einen Verkündungstermin im Fall I ZR 281/25 angesetzt. Was verkündet wird, ist offen: denkbar ist eine Entscheidung, denkbar eine Vorlage an den EuGH. Eine Vorlage würde das Verfahren verlängern, weil dann zuerst der EuGH antwortet.
Ist das Token verbindlich? OpenAI nennt es freiwillig. Verbindlichkeit kann nur aus dem Gesetz kommen: Liegt ein wirksamer Vorbehalt nach § 44b Abs. 3 vor, ist die Nutzung nach dieser Schranke nicht mehr zulässig. Ob das Token ein solcher Vorbehalt ist, ist offen.
Fazit
Die Schlagzeile ist eine Zeile Text. Die ehrliche Fassung ist länger: Es ist eine gute, kleine Idee, nämlich einmal sagen, und alle Beteiligten können es lesen. Sie ist noch nicht überall in Betrieb, nicht durchsetzbar und holt bereits Gesammeltes nicht zurück. Dazu kommt in Deutschland die Rechtsfrage, ob so eine Zeile ein „maschinenlesbarer“ Vorbehalt nach § 44b Abs. 3 ist. Die Gerichte haben sie bisher an einem Fall von 2021 mit einem Hinweis in Nutzungsbedingungen und Quellcode der Agentur behandelt (so Ehlers), und der BGH hat sie am 3. September 2026 aufgeworfen, aber bis zum 31. Oktober 2026 nicht beantwortet.
Die Entscheidung dahinter bleibt dieselbe: Du wägst „gelesen werden“ gegen „benutzt werden“ ab. Bei OpenAI, Anthropic und ab 1. Februar 2027 bei Microsoft kannst du beides trennen. Stand 31. Oktober 2026 hängen sie bei Google zusammen (Google-Extended). Entscheide, was dir wichtiger ist, schreib es auf, behalte deine Regeln pro Bot und schau nach dem 17. Dezember 2026 und dem 1. Februar 2027 noch einmal hin.
Die rechtliche Seite vertieft KI-Recht & Regulierung (erste 2 Lektionen gratis); Lektion 4 behandelt das Urheberrecht und den Opt-out nach § 44b. Wie du in KI-Antworten überhaupt genannt wirst, behandelt Lokales SEO und Google AI Overviews (erste 2 Lektionen gratis). Für die kreative Seite gibt es Fotografie mit KI (erste 2 Lektionen gratis).
Dein erster Schritt heute Abend ist klein: Öffne deine eigene robots.txt, lies sie einmal durch und notiere, welche der vier Fragen du noch nicht beantworten kannst.
Quellen
- § 44b UrhG (Gesetze im Internet)
- § 60d UrhG (Gesetze im Internet)
- Richtlinie (EU) 2019/790 (EUR-Lex)
- BGH, Pressemitteilung Nr. 085/2026, I ZR 281/25
- BGH, Terminübersicht (Verkündungstermin)
- Heidrich Rechtsanwälte, Pressemeldungen zum Verfahren LAION
- BFF, Stellungnahme zur BGH-Verhandlung, 9. September 2026
- Initiative Urheberrecht, Kommentar zum OLG-Urteil
- Jan Ehlers, OLG Hamburg zum LAION-Fall
- Legal Tribune Online, Ostendorff, 15. Oktober 2024
- LG München I, Pressemitteilung 11/2025 (GEMA gegen OpenAI)
- Beurskens (Universität Passau), Merkblatt KI-Crawler
- Lausen Rechtsanwälte, TDM-Vorbehalt und Maschinenlesbarkeit, 22. Juli 2024
- IT-Recht Kanzlei, 14. November 2025
- Legal Tribune Online, Kuhlmann, 1. August 2025
- EU-Kommission, Konsultation zu Protokollen für Rechtevorbehalte
- InfoCuria, C-250/25 Like Company
- IETF-Entwurf draft-kelley-aipref-training-preference-signal-00
- Kevin Kelley, Nachricht an die IETF-Liste ai-control
- Google Search Central Blog, 30. Oktober 2026
- Google, Common Crawlers (Google-Extended)
- OpenAI, Ankündigung vom 30. Oktober 2026
- OpenAI, Crawler-Dokumentation
- Microsoft Bing Blog, 30. Oktober 2026
- Anthropic Help Center, Crawler
- Squarespace Help, Block known artificial intelligence crawlers