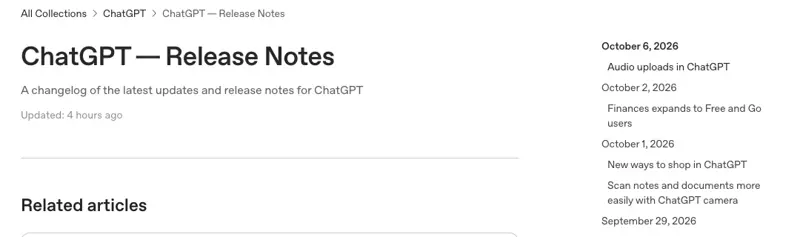
Seit dem 6. Oktober kannst du in ChatGPT eine Audiodatei anhängen und daraus ein Transkript, strukturierte Notizen oder den Entwurf einer Follow-up-Mail machen lassen. Das Einschränkende steht bei OpenAI im Klartext: Audio-Uploads gibt es nur in bezahlten Tarifen und Workspaces, im Free-Tarif „zu diesem Zeitpunkt" nicht. Und das Zweite steht in keiner Release Note, sondern im deutschen Strafgesetzbuch: Wessen Stimme auf der Datei ist, sollte vor dem Aufnehmen einverstanden gewesen sein, und das Einverständnis holt das Tool nicht für dich ein.
Wer in Deutschland nach dem Thema sucht, bekommt derzeit vor allem zwei Sorten Seiten: Anbieter-Blogs, die „ChatGPT transkribiert über Whisper, maximal 25 MB" erzählen, und Rechtstexte, die ChatGPT nicht erwähnen. Beides hilft dir halt nicht weiter. Hier steht deshalb beides zusammen. Erstens, was OpenAI tatsächlich dokumentiert und was an den deutschen Fassungen veraltet ist. Zweitens, wie du aus einer Aufnahme belastbare Notizen machst. Drittens, was § 201 StGB, DSGVO, Betriebsrat und Beschäftigtendatenschutz für das Hochladen bedeuten. Ich bin kein Jurist. Wo ich Recht wiedergebe, steht die Quelle direkt daneben, und wo ich etwas nicht bestätigen konnte, sage ich das.
So habe ich recherchiert
Am 7. Oktober habe ich die Release Note vom 6. Oktober, OpenAIs Hilfeartikel „Uploading files and audio to ChatGPT", die Seiten zu Record und Meetings-Plugin, die OpenAI-Datenschutzerklärung für Europa, das Data Processing Addendum und die Seite zur Datenresidenz geöffnet. Auf deutscher Seite habe ich den Gesetzestext von § 201 StGB, § 26 BDSG und § 87 BetrVG gelesen. Dazu kamen das GDD-Kurzpapier „Gesprächstranskription" (Januar 2026), das GDD-Konzept zur KI-Transkription von Videokonferenzen (Version 1.2, Juni 2026), die Orientierungshilfe „KI und Datenschutz" der Datenschutzkonferenz, ein BAG-Beschluss, Statistiken von Destatis und Bitkom und eine heise-Podcastfolge von vor fünf Tagen.
Was ich nicht getan habe: die Funktion mit eigenen Testdateien auf einem Bezahlkonto durchgespielt. Wo ich Verhalten beschreibe, beschreibe ich also, was OpenAI dokumentiert, nicht, was ich gemessen habe. Auf X habe ich nach deutschsprachigen Reaktionen gesucht und stand heute praktisch nichts gefunden.
Was hier eigentlich passiert ist
Die Release Note vom 6. Oktober ist kurz. Übersetzt lautet der Kern:
„Lade Audiodateien in ChatGPT hoch, um Transkripte zu erstellen, Aufnahmen zusammenzufassen und Fragen zu ihrem Inhalt zu stellen. Du kannst ein Meeting, ein Interview oder eine Vorlesung in strukturierte Notizen oder den Entwurf einer Follow-up-Mail verwandeln." (OpenAI, Release Notes, 6. Oktober 2026, sinngemäß übersetzt)
Und im Kleingedruckten: Audio-Uploads gibt es nur bei bezahlten Abos und Workspaces, mit Einschränkungen bei Region und Version (Details unten).
Technisch ist das ein Dateianhang, keine neue App. Du schaltest keinen Spezialmodus ein, sondern hängst eine Audiodatei so an wie ein PDF, sagst, was du willst, und fragst danach im selben Chat weiter. Das ist der eigentliche Gewinn. Ein Transkript allein ist eine Textwüste. Ein Transkript in einem Chat, in dem du fragen kannst „Was hat die Kundin zum Liefertermin gesagt?" oder „Formuliere eine Mail, die die drei vereinbarten Punkte bestätigt", ist ein Arbeitsdokument.
Drei Funktionen, die gerade durcheinandergeraten
Daneben hat OpenAI zwei weitere Audio-Funktionen im Programm. Die Berichte darüber verschwimmen, dabei gelten für jede andere Regeln:
- Audio-Uploads (neu, 6. Oktober): Du hast die Aufnahme schon als Datei und hängst sie an einen Chat. Verfügbar in bezahlten Tarifen und Workspaces. ChatGPT nimmt dabei nichts auf.
- Record (älter): Ein Aufnahme-Knopf in der macOS-Desktop-App, der live mithört und Notizen baut. Laut OpenAIs Record-Seite für Plus, Pro, Business, Enterprise und Edu, ausschließlich auf macOS.
- Das Meetings-Plugin (neu, 29. September): Ebenfalls nur macOS, Beta für alle Pro- und Business-Tarife, bei Enterprise eine begrenzte Alpha. Es schreibt in einem Call mit, ohne dass ein Bot beitritt, und legt danach eine Zusammenfassung mit vorgeschlagenen Aufgaben in einem ChatGPT Space ab.
Wenn du hörst „ChatGPT kann jetzt meine Meetings aufnehmen", ist das Record oder Meetings. Wenn du hörst „ChatGPT transkribiert jetzt meine Sprachmemo", sind das die Audio-Uploads, um die es hier geht. (Falls dir die ganze Kategorie neu ist: Unsere Glossarseite Was ist ein KI-Notetaker? gibt es bislang nur auf Englisch, erklärt aber die Grundlagen.)
Was an den deutschen Suchergebnissen veraltet ist
Bevor du irgendeiner Anleitung glaubst: Ich habe am 7. Oktober geprüft, was deutschsprachige Anbieterseiten zum Thema behaupten. Mehrere sind erst Monate alt und trotzdem schon überholt, weil sich die Lage am 6. Oktober geändert hat.
| Behauptung auf deutschen Seiten | Wo ich sie gefunden habe | Stand 7. Oktober 2026 laut OpenAI |
|---|---|---|
| „Die Dateigröße ist auf 25 MB begrenzt." | Transkriptor, Artikel vom 3. April 2026; VexaScribe („~26 Minuten passen in 25 MB"), „Verifiziert 15. August 2026" | In ChatGPT: 512 MB pro Audiodatei. Die 25 MB gehören zur separaten Entwickler-API (Speech-to-Text), nicht zur ChatGPT-App. |
| „ChatGPT transkribiert Audio über das Whisper-Modell." | Transkriptor, VexaScribe („Backend ist OpenAIs Whisper") | OpenAI nennt in den Hilfeseiten kein Modell hinter den Uploads. Die Behauptung ist als Tatsache nicht belegt. |
| „Die maximale Dateilänge beträgt ca. 25 Minuten." | Voicit, „Aktualisiert: März 2026" | OpenAI nennt keine Minutenobergrenze, sondern 512 MB und den Hinweis, dass sehr lange Aufnahmen in Abschnitten verarbeitet werden und in einen Timeout laufen können. |
| „Audio-Dateien können hochgeladen werden, werden jedoch nicht automatisch transkribiert." | ClickUp, 20. Juni 2025 | Seit dem 6. Oktober dokumentiert OpenAI den Transkript-Anwendungsfall ausdrücklich („Ask for a transcript of an audio recording"). |
| „Ab Plus, Team und Enterprise" | VexaScribe; Transkriptor („Plus-, Team- oder Enterprise-Abos") | Im Kern richtig, aber ungenau: OpenAI schreibt „paid subscriptions and workspaces, including Enterprise" und listet keine einzelnen Tarife. Ob Go oder Pro dazugehören, steht nicht im Text. |
| „Keine Sprechererkennung" | VexaScribe, Voicit | Nuancierter: OpenAI sagt, die Sprecheridentifikation „may be unreliable". Es ist also nicht „gibt es nicht", sondern „verlass dich nicht darauf". |
Zwei Anmerkungen dazu. Erstens stammen diese Seiten größtenteils von Anbietern, die dir ein eigenes Transkriptionstool verkaufen, und der Vergleich fällt entsprechend aus. Zweitens beantwortet keine davon die DSGVO-Frage, um die es vielen deutschen Lesern im Kern geht. Transkriptor führt in seiner eigenen Vergleichstabelle für ChatGPT bei DSGVO/SOC 2 den Eintrag „Keine Angabe für Endverbraucherprodukte".
Die Fakten aus OpenAIs Hilfeartikel
Die Details stehen im Hilfeartikel „Uploading files and audio to ChatGPT". Ich habe sie hier sortiert.
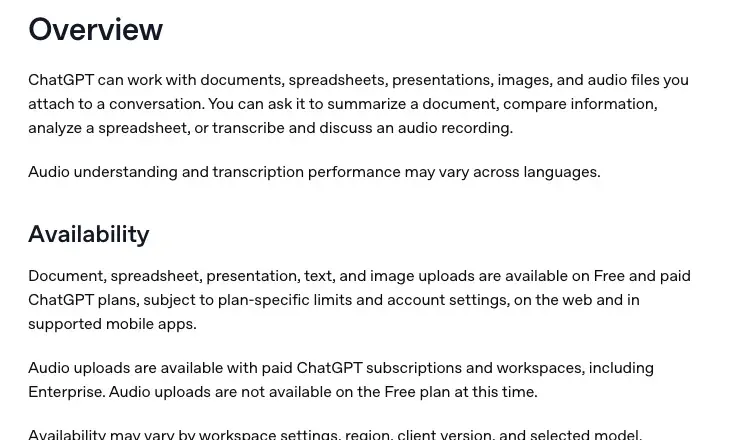
Wer es bekommt. Bezahlte ChatGPT-Abos und -Workspaces, einschließlich Enterprise. Im Free-Tarif „zu diesem Zeitpunkt" nicht. Dazu steht im Artikel, die Verfügbarkeit könne je nach Workspace-Einstellungen, Region, App-Version und Modell variieren. Eine Länderliste habe ich nicht gefunden. Ob Deutschland uneingeschränkt dabei ist, kann ich dir deshalb nicht verbindlich sagen. Prüf es in deiner App, bevor du eine Entscheidung darauf aufbaust.
Welche Dateien funktionieren. WAV, MP3/MPEG, OGG/OGA, reine Audio-WebM, PCM, FLAC, AAC, M4A und reine Audio-MP4. Das deckt die Sprachmemo vom Handy ab (meist M4A), die Exportdatei einer Call-App und die meisten Diktiergeräte. Der Haken: WebM- und MP4-Dateien, die als Video erkannt werden, sind für Audio-Uploads nicht unterstützt. Die Aufzeichnung einer Teams- oder Zoom-Sitzung liegt oft als MP4-Video vor. Du musst die Tonspur also zuerst separat exportieren. Außerdem muss die Datei einen gültigen, dekodierbaren Audiostream enthalten.
Wie groß. „Audio files can be up to 512 MB." Längere Aufnahmen könnten, wo die Datenanalyse verfügbar ist, in kleineren Abschnitten verarbeitet werden. Die Verarbeitung sei „best-effort", sehr lange Aufnahmen könnten in einen Timeout laufen.
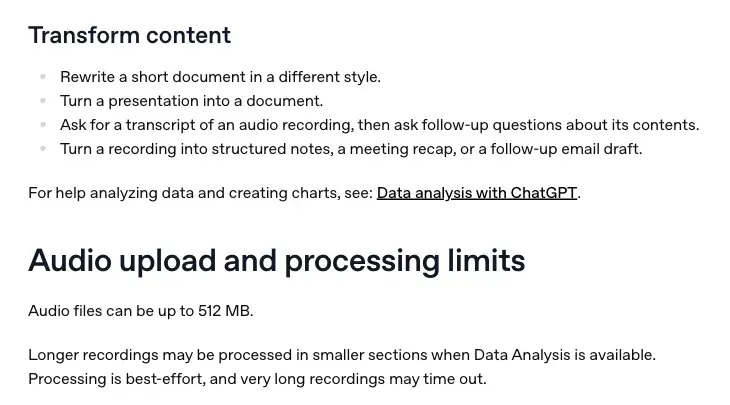
Beachte, was fehlt: Es gibt keine garantierte Maximaldauer in Minuten oder Stunden. Dazu kommen die allgemeinen Upload-Raten: Laut Artikel sind es bis zu 80 Dateien alle drei Stunden, im Free-Tarif nur drei Datei-Uploads pro Tag, und OpenAI behält sich vor, die Limits in Stoßzeiten zu senken. Der gemeinsame Upload-Speicher ist auf 25 GB pro Person und 100 GB pro Organisation begrenzt.
Wie genau. Der Artikel sagt sinngemäß: Transkripte können Fehler enthalten, die Sprecheridentifikation kann unzuverlässig sein, prüfe wichtige Details anhand der Originalaufnahme. Und die Leistung kann je nach Sprache schwanken. Für ein deutschsprachiges Publikum ist das Letzte das Wichtigste, dazu unten mehr.
Wofür es gedacht ist. OpenAIs Beispiele: ein Meeting mit Entscheidungen, offenen Fragen und nächsten Schritten zusammenfassen, Fragen zu einer Aufnahme stellen, Kernpunkte aus Interview oder Vorlesung ziehen, ein Transkript anfordern und danach nachfragen, daraus Notizen, einen Recap oder eine Follow-up-Mail machen.
Schritt für Schritt, mit dem Schritt, den keine Anleitung nennt
OpenAI braucht dafür drei Zeilen: Datei anhängen, beschreiben, was du willst, Antwort prüfen. Hier die Langfassung in der Reihenfolge, die in Deutschland sinnvoll ist. Der Schritt davor ist der wichtigste.
Schritt 0: Klär, ob du aufnehmen darfst. Bevor du auf Aufnehmen drückst, nicht danach. Wer außer dir spricht, muss wissen, dass aufgenommen wird, und wofür. Die Details stehen im Kapitel „Darfst du das aufnehmen?" weiter unten. Ergebnis: Du hast ein klares „Ja" von jeder Person, deren Stimme später auf der Datei ist, und kannst es belegen (am besten, indem es mit auf der Aufnahme ist).
Schritt 1: Datei in ein unterstütztes Format und eine vernünftige Größe bringen. Sprachmemos von iPhone oder Android passen meist direkt. Stammt die Aufnahme aus einem Videocall, exportier nur den Ton. Ist es eine riesige WAV-Datei, wandle sie vorher in MP3 oder M4A um (die Rechnung unten zeigt, warum).
Schritt 2: Neuen Chat öffnen, Datei anhängen. Nimm die Anhängen-Funktion im Eingabefeld, dieselbe wie bei einem PDF, und starte pro Aufnahme einen frischen Chat, damit die Notizen eines Kunden nicht in die eines anderen rutschen.
Schritt 3: Sag konkret, was du willst. Zwischen einer brauchbaren und einer vagen Antwort liegt eigentlich nur diese Nachricht. „Transkribier das" liefert ein Transkript. „Gib mir eine Zusammenfassung, Beschlüsse, offene Fragen mit Verantwortlichen und nächste Schritte" liefert etwas, das du ins CRM kopieren kannst. Einen Prompt zum Kopieren findest du im Beispiel unten.
Schritt 4: Gegen die Aufnahme prüfen. Bevor irgendetwas an irgendwen rausgeht, hör dir die zwei, drei Stellen an, auf die es ankommt: jede Zahl, jedes Datum, jeden Namen, jedes „Ja, einverstanden". OpenAI rät selbst dazu, und es ist die wertvollste Gewohnheit bei jedem Speech-to-Text-Werkzeug.
Schritt 5: Im selben Chat nachfragen. Hier schlägt der Upload ein reines Transkriptionstool. Frag „Wer wollte das überarbeitete Angebot schicken, und bis wann?" oder „Formulier die Aufgaben als freundliche Mail an die Kundin um."
Schritt 6: Entscheiden, wo die Datei bleibt. Laut Hilfeartikel sind das Löschen einer Unterhaltung und das Löschen einer gespeicherten Datei zwei getrennte Vorgänge: Dateien in der Library können unabhängig vom Chat aufbewahrt werden, und „Deleting a chat does not delete a file that remains saved in Library". Laut Release Notes ersetzt der Space die Library, falls dein Konto ihn hat. Ist die Aufnahme heikel, lösch die gespeicherte Kopie bewusst.
Ein Beispiel von der Datei bis zur Mail
Ich zeige keine echte Kundenaufnahme und habe keinen Live-Test gemacht. Die Zahlen unten sind Rechnungen, die du nachprüfen kannst. Das Gesprächsbeispiel ist ausgedacht und kein echtes ChatGPT-Ergebnis.
Die Ausgangslage
Eine Projektleiterin in einem mittelständischen Maschinenbauer führt einen 45-minütigen Jour fixe mit vier Personen: sie selbst, zwei Kollegen aus dem Vertrieb und der Einkauf eines Kunden, der per Videocall dabei ist. Sie will daraus Notizen und eine Bestätigungsmail machen. Die Datei entsteht auf ihrem Smartphone als M4A.
Die Rechnung mit der Dateigröße
Die 512-MB-Grenze klingt riesig, bis man mal nachrechnet, wie schnell Audio wächst. Die Größe hängt von der Bitrate ab, und die vom Speicherformat. Gerechnet mit Dezimal-Megabyte (1 MB = 1.000.000 Byte):
| Wie die Aufnahme gespeichert wurde | Bitrate | Größe pro Minute | 45-Minuten-Meeting | Minuten bis 512 MB |
|---|---|---|---|---|
| MP3 oder M4A, Sprachqualität | 64 kbit/s | 0,48 MB | rund 22 MB | rund 1.067 (17,8 Stunden) |
| MP3 oder M4A, Standardqualität | 128 kbit/s | 0,96 MB | rund 43 MB | rund 533 (8,9 Stunden) |
| WAV, 16 Bit, mono, 16 kHz | 256 kbit/s | 1,92 MB | rund 86 MB | rund 267 (4,4 Stunden) |
| WAV, 16 Bit, stereo, 44,1 kHz (CD-Qualität) | 1.411 kbit/s | 10,6 MB | rund 476 MB | rund 48 Minuten |
Drei Schlüsse daraus. Erstens: Eine normale MP3- oder Handy-Sprachmemo kommt der Obergrenze praktisch nie nahe, die Dateigröße ist nicht dein Problem. Zweitens: Eine unkomprimierte WAV-Aufnahme in CD-Qualität kommt bei 45 Minuten schon auf rund 476 MB, knapp unter die Grenze. Bei 50 Minuten läge sie darüber. Als MP3 schrumpft dieselbe Datei auf etwa ein Elftel, und bei Sprache geht dabei nichts Wesentliches verloren. Drittens: Das eigentliche Problem bei sehr langen Dateien ist nicht die Obergrenze, sondern OpenAIs Warnung, dass die Verarbeitung nur „best-effort" läuft und in einen Timeout laufen kann. Bei dreistündigen Aufnahmen teilst du die Datei besser in Ein-Stunden-Stücke. Das dürfte robuster laufen als ein Riesending (belegt ist das nicht).
Zum Vergleich: Die 25 MB der Entwickler-API entsprächen bei 128 kbit/s etwa 26 Minuten (25.000.000 Byte geteilt durch 16.000 Byte pro Sekunde sind rund 1.562 Sekunden). Aus dieser Zahl stammt der Rat in älteren Artikeln, Aufnahmen zu zerschneiden. In der ChatGPT-App brauchst du das bis zu den oben genannten Grenzen nicht.
Für unseren Jour fixe heißt das: M4A mit 128 kbit/s, 45 Minuten, rund 43 MB. Locker unter 512 MB, kein Zerschneiden nötig.
Vor dem Upload: die halbe Minute Einwilligung
Zu Beginn des Calls sagt die Projektleiterin, deutlich und für alle hörbar, damit es auch auf der Aufnahme ist:
„Bevor wir anfangen: Ich nehme dieses Gespräch auf meinem Handy auf und lasse mir daraus mit einem KI-Dienst, ChatGPT von OpenAI, Notizen und eine Zusammenfassung erstellen. Die Aufnahme dient nur dazu, dass ich nichts Falsches protokolliere, und ich lösche sie, sobald das Protokoll fertig ist. Seid ihr damit einverstanden? Wer nicht möchte, sagt das jetzt oder jederzeit, dann schalte ich ab."
Dann wartet sie auf ein hörbares „Ja" von jeder Person und fängt erst danach inhaltlich an. Eine halbe Minute, ungefähr. (Warum die Ansage genau so aufgebaut ist, erkläre ich im Rechtsteil.)
Der Prompt (zum Kopieren)
Der Prompt steht auf Englisch, weil KI-Prompts auf Englisch in der Regel robuster funktionieren. Die Ausgabe verlangst du auf Deutsch:
This is a recording of a German-language project meeting with four participants. Please answer in German.

1. Give me a 5-sentence summary in plain language.
2. List every decision that was made, one line each, and who made it.
3. List open questions nobody answered, with the person who should answer each.
4. List action items as: owner / what / by when (write "kein Termin genannt" if no date was said).
5. Flag everything where you are not confident in the transcript: names, numbers, amounts, dates, product codes. Quote the passage and give the approximate timestamp.
6. Draft a short, friendly follow-up email to the customer that confirms only the decisions and next steps. Do not add any commitment that was not said in the meeting.

Do not guess names or numbers. If you cannot tell, say so.
Punkt 5 und der letzte Satz sind die wichtigen. Sie erlauben dem Modell, „Ich bin nicht sicher" zu sagen, statt ein undeutlich gesprochenes Wort mit einer selbstbewusst klingenden Vermutung zu überdecken.
Die Prüfung, die man mit Taschenrechner machen kann
Angenommen, im Meeting fällt dieser Satz (ausgedachtes Beispiel, kein ChatGPT-Output): „Dann bleiben wir beim Angebot über zwölftausendvierhundertachtzig Euro netto, Lieferung in Kalenderwoche siebenundvierzig." In der Mail muss dann eine Zahl stehen, die zu dir passt. Rechne es gegen: 12.480 € netto mal 1,19 ergibt 14.851,20 € brutto. Steht in der Zusammenfassung 12.840 oder 12.048 oder ein Bruttobetrag, der sich nicht aus 12.480 ergibt, ist das ein Warnsignal, und du spielst genau diese Stelle noch einmal ab. Kalenderwoche 47 ist 2026 übrigens die Woche vom 16. bis 22. November. Auch das prüfst du im Kalender, bevor es in einer Kundenmail steht.
Worauf ich hinaus will: Nimm bei Sprache-zu-Text nie an, dass eine Zahl stimmt, nur weil sie sauber formatiert ist. Das gilt besonders im Deutschen, wo „fünfzehn" und „fünfzig", „dreizehn" und „dreißig" sich akustisch ja ziemlich nahe liegen und wo Tausenderpunkt und Dezimalkomma gegenüber englischen Formaten vertauscht sind. Das sind plausible Fehlerquellen, keine dokumentierten.
Und danach?
Die Projektleiterin prüft die drei, vier Stellen mit Zahlen und Zusagen, schickt die Mail ab, löscht die Datei in der Library bzw. im Space, löscht die Sprachmemo auf dem Handy und notiert im Projektordner in einer Zeile: „Aufnahme am 7.10. mit Einwilligung aller, gelöscht am 7.10." Das ist keine Pflichtübung, sondern der Beleg, den du brauchst, falls später jemand fragt.
Darfst du das aufnehmen? Der deutsche Rechtsteil
Das ist der Teil, zu dem viele Leser in Deutschland eigentlich gekommen sind. Die Frage lautet: „Darf ich ein Gespräch aufnehmen und von einer US-KI auswerten lassen?" Das sind zwei Fragen mit zwei verschiedenen Rechtsgrundlagen. Die eine betrifft die Aufnahme (Strafrecht), die andere die Verarbeitung (Datenschutzrecht). Wer die eine bejaht, hat die andere noch nicht beantwortet.
Kein Rechtsrat. Bei konkreten Fällen, besonders bei Berufsgeheimnis, Personalgesprächen oder Verträgen, frag eine Fachperson.
§ 201 StGB: die Aufnahme
Der Gesetzestext ist kurz. Nach § 201 Abs. 1 StGB wird mit Freiheitsstrafe bis zu drei Jahren oder mit Geldstrafe bestraft, wer unbefugt das nichtöffentlich gesprochene Wort eines anderen auf einen Tonträger aufnimmt (Nr. 1) oder eine so hergestellte Aufnahme gebraucht oder einem Dritten zugänglich macht (Nr. 2). Der Versuch ist strafbar (Abs. 4). Das steht auf gesetze-im-internet.de.
Daraus lassen sich drei Dinge ablesen, die für dich praktisch sind:
- „Das Wort eines anderen." Deine eigene Sprachmemo, in der nur du sprichst, ist vom Wortlaut her nicht erfasst. Das Strafrecht ist hier also nicht dein Problem, wohl aber das Datenschutzrecht, sobald du über andere Personen sprichst (dazu unten).
- „Nichtöffentlich." Ein Gespräch zwischen zwei Menschen am Küchentisch oder in einer Videokonferenz mit geschlossenem Teilnehmerkreis dürfte nichtöffentlich sein. Wie es bei einer Vorlesung, einer Podiumsdiskussion oder einer Betriebsversammlung aussieht, hängt vom Einzelfall und den jeweiligen Regeln ab. Frag vorher.
- Nr. 2 betrifft auch das Weiterverwenden. Der Text spricht nicht nur von der Aufnahme, sondern auch vom „Gebrauchen" und „einem Dritten zugänglich machen", bezogen auf eine „so hergestellte", also unbefugt gemachte Aufnahme. Ob das Hochladen bei einem KI-Anbieter darunter fallen kann, halte ich nach dem Wortlaut nicht für ausgeschlossen. Ob und wie Gerichte das einordnen, habe ich nicht gefunden. Ein weiterer Grund, die Einwilligung ausdrücklich auf das KI-Hochladen zu erstrecken (wie in der Ansage oben).
Was reicht als Einwilligung? Hier gehen die Auffassungen auseinander. Das GDD-Kurzpapier „Gesprächstranskription" (Stand Januar 2026) schreibt: Strafrechtlich genüge eine konkludente Zustimmung, etwa Weiterreden trotz Hinweis auf die Aufzeichnung, datenschutzrechtlich brauche es dagegen eine ausdrückliche, dokumentierte Einwilligung. Die heise-Podcastfolge „Auslegungssache 169" vom 2. Oktober 2026 hält den Grundsatz „wer bleibt, willigt ein" nach Darstellung von heise für rechtlich nicht tragfähig. Beide Quellen betonen, dass klare Information vorab zentral ist. Mein Schluss daraus, und das ist keine Rechtsauskunft, sondern Vorsicht: Frag ausdrücklich, warte auf das „Ja", lass es auf der Aufnahme.
DSGVO: die Verarbeitung
Eine Sprachaufnahme ist ein personenbezogenes Datum, sobald sich eine Person erkennen oder identifizieren lässt. Das GDD-Kurzpapier sagt dazu: Technisch erfolge eine Transkription durch eine Zwischenspeicherung des Audiosignals, und bereits diese Zwischenspeicherung sei eine Verarbeitung personenbezogener Daten. Für dich heißt das: Sobald andere Menschen auf deiner Datei zu hören sind, brauchst du außerhalb rein privater Nutzung (dazu gleich) eine Rechtsgrundlage nach Art. 6 DSGVO.
Das GDD-Papier geht die vier infrage kommenden Grundlagen durch. In der Praxis laufe es meist auf die Einwilligung hinaus. Sie müsse freiwillig, informiert und jederzeit widerruflich sein, und eine aktive Handlung erfordern. Stillschweigen, vorangekreuzte Optionen oder automatisch aktivierte Funktionen reichten nicht aus. Vertragserfüllung, gesetzliche Pflicht und berechtigtes Interesse seien denkbar, aber „nicht der praktische Regelfall". Beim berechtigten Interesse betont das Papier: Wenn ein manuelles Protokoll als milderes Mittel ausreicht, fehle es an der Erforderlichkeit.
Vor der Einwilligung müssen die Betroffenen laut GDD informiert werden: Zweck, Umfang, vorgesehene Speicherdauer, mögliche Empfänger und die eingesetzten Systeme (ausdrücklich genannt: KI-gestützte Transkriptionssoftware), dazu der Hinweis auf jederzeitigen Widerruf. Das sind die Punkte, die die Ansage oben abdeckt: Zweck (Notizen), System (ChatGPT/OpenAI), Speicherdauer (bis zum Löschen), Widerruf. Die Informationspflichten selbst stehen in Art. 13 und Art. 14 DSGVO.
Die Orientierungshilfe der Datenschutzkonferenz (DSK) von 2024 sagt: Um personenbezogene Daten zu vermeiden, reiche es regelmäßig nicht, Namen und Anschriften zu entfernen, weil sich aus dem Zusammenhang häufig ein Personenbezug herstellen lasse. Ein „anonymisiertes" Transkript, in dem du bloß die Namen durch „Kunde A" ersetzt hast, ist also nicht automatisch anonym. Der Satz gilt doppelt für Audio: Eine Stimme lässt sich nicht „schwärzen".
Privat oder beruflich? Die DSGVO gilt nach Art. 2 Abs. 2 lit. c nicht für die Verarbeitung durch natürliche Personen „zur Ausübung ausschließlich persönlicher oder familiärer Tätigkeiten" (Text der Verordnung). Eine Sprachmemo über deinen Einkaufszettel oder die Wohnungsübergabe an deinen Bruder fällt darunter. Ein Kundengespräch, ein Interview für dein Magazin, ein Team-Meeting dagegen nicht: Dort bist du in beruflicher Rolle, und das Wort „ausschließlich" steht dem Privileg entgegen.
Die US-Frage: Wer ist der Anbieter und wohin gehen die Daten?
Das ist die Frage, die in Deutschland nun mal viel Skepsis auslöst. Die Antwort ist nicht ganz einfach.
- Wer verantwortlich ist. Nach OpenAIs Datenschutzerklärung für Europa ist für Nutzer im Europäischen Wirtschaftsraum und in der Schweiz die OpenAI Ireland Limited (Dublin) Verantwortliche. Als verarbeitete Inhalte nennt die Erklärung ausdrücklich auch hochgeladene Dateien, Bilder, Audio und Video.
- Wie in Drittländer übermittelt wird. OpenAI schreibt, für Länder ohne Angemessenheitsbeschluss berufe man sich auf die Standardvertragsklauseln der EU-Kommission nach Art. 46 Abs. 2 lit. c DSGVO. Das EU-US Data Privacy Framework hat das Gericht der EU am 3. September 2025 bestätigt (Heuking). Mehreren Kanzlei-Berichten zufolge wurde dagegen Rechtsmittel zum EuGH eingelegt (WilmerHale). Auf welches Instrument sich OpenAI bei einem konkreten Upload stützt, habe ich nicht geprüft. Prüf den aktuellen Stand, wenn du es beruflich brauchst.
- Was die Aufsichtsbehörden grundsätzlich sagen. Die DSK nennt Cloud-KI „offene Systeme": Die Eingabedaten verlassen den geschützten Bereich der Anwender, es bestehe das Risiko der Weiterverarbeitung zu anderen Zwecken und der Offenlegung gegenüber Dritten, und Drittstaatenübermittlungen seien nach Kapitel V DSGVO zu beachten. Datenschutzrechtlich vorzugswürdig seien Anwendungen, die Ein- und Ausgabedaten nicht zu Trainingszwecken verwenden.
- Was das GDD für Dienstleister verlangt. Mit dem technischen Dienstleister ist vor dem Einsatz ein Auftragsverarbeitungsvertrag nach Art. 28 DSGVO zu schließen. Er müsse eine Nutzung von Audio-, Transkriptions-, Inhalts- und Metadaten für das Training allgemeiner KI-Modelle ausschließen, soweit keine gesonderte tragfähige Grundlage besteht.
Die Konsequenz: Auf einem privaten Konto läuft die Nutzung über OpenAIs Verbraucherbedingungen, und OpenAI ist nach der Datenschutzerklärung selbst Verantwortliche. Einen Auftragsverarbeitungsvertrag nach Art. 28 gibt es dort nach meinem Stand nicht. Das OpenAI Data Processing Addendum (wirksam seit 1. Januar 2026) ergänzt nämlich den OpenAI Services Agreement, also den Geschäftskunden-Vertrag, und wird für Kunden im EWR oder in der Schweiz mit der OpenAI Ireland Ltd. geschlossen. Ob es für deinen Tarif gilt, steht in deinen Vertragsunterlagen.
Datenresidenz: gibt es das für Audio-Uploads?
OpenAIs Hilfeseite zur Datenresidenz (Stand 7. Oktober, „Updated: 3 days ago") sagt: Datenresidenz für ChatGPT steht berechtigten API-Kunden und neuen ChatGPT-Enterprise-/Edu-Kunden zur Verfügung, Europa (EWR plus Schweiz) ist eine von zehn Regionen. Gespeichert werden in der gewählten Region unter anderem Unterhaltungen (Text, Bild, Sprache) und Dateien. Dann kommt der Satz, der für dich zählt: Neue Funktionen oder Modalitäten seien nicht datenresidenzfähig, solange sie nicht aufgelistet sind. Audio-Uploads stehen nicht ausdrücklich in dieser Liste. Ob hochgeladene Audiodateien in einem europäischen Enterprise-Workspace in Europa liegen, kann ich deshalb nicht sagen. Frag bei OpenAI nach, bevor du Berufliches hochlädst. Für Business-Tarife und die privaten Tarife (Go, Plus, Pro) nennt die Seite überhaupt keine Residenzoption, und Metadaten, Abrechnungsdaten, Logins und bestimmte transiente Verarbeitungsschritte können auch bei Enterprise außerhalb der Region liegen.
Die Tabelle fasst zusammen, was OpenAI sagt:
| Konto | Vertragsrahmen | Training mit deinen Inhalten | Wo gespeichert | Offene Frage für Audio |
|---|---|---|---|---|
| Free | Verbraucherbedingungen | Audio-Uploads nicht verfügbar | n. a. | n. a. |
| Bezahlte Privat-Tarife (Go, Plus, Pro; sofern Audio bei dir freigeschaltet ist) | Verbraucherbedingungen; OpenAI Ireland Limited ist Verantwortliche | „Hängt von deinen Datenkontroll-Einstellungen ab" (OpenAI) | keine Residenzoption genannt | Schalter prüfen; Library bzw. Space löschen |
| Business / Enterprise | OpenAI Services Agreement plus DPA (für EWR-Kunden mit OpenAI Ireland) | OpenAI: kein Training mit Inhalten aus Business-Angeboten wie API und Enterprise | Business: keine Residenz erwähnt; Enterprise/Edu: nur neue Workspaces | Audio-Uploads nicht in der Residenz-Liste aufgeführt |
Die Training-Zeile ist auf Basis des Hilfeartikels geschrieben: Für Verbraucherdienste hänge es „von den Datenkontrolleinstellungen" ab, und OpenAI nutze Inhalte aus Business-Angeboten „wie der API und ChatGPT Enterprise" nicht zur Verbesserung der Modelle. Den Tarif „Business" nennt dieser Satz nicht namentlich. Dazu verweist OpenAI auf seine Enterprise-Privacy-Seite. Prüf den Stand für deinen Tarif dort.
Beschäftigte: Betriebsrat, Freiwilligkeit, Schatten-KI
Okay, jetzt wird es konkret, und hier sind die deutschen Besonderheiten am größten.
Freiwilligkeit. § 26 Abs. 2 BDSG sagt, dass bei einer Einwilligung im Beschäftigungsverhältnis für die Beurteilung der Freiwilligkeit „insbesondere die im Beschäftigungsverhältnis bestehende Abhängigkeit der beschäftigten Person sowie die Umstände" zu berücksichtigen sind (Gesetzestext). Das GDD schließt daraus: Eine Einwilligung kann hier im Einzelfall als nicht freiwillig gelten, deshalb biete sich oft eine Betriebsvereinbarung an.
Mitbestimmung. § 87 Abs. 1 Nr. 6 BetrVG gibt dem Betriebsrat ein Mitbestimmungsrecht bei der „Einführung und Anwendung von technischen Einrichtungen, die dazu bestimmt sind, das Verhalten oder die Leistung der Arbeitnehmer zu überwachen" (Gesetzestext). Das Bundesarbeitsgericht legt das weit aus: Mitbestimmungspflichtig sind technische Einrichtungen, wenn sie objektiv geeignet sind, Verhalten oder Leistung zu überwachen. In seinem Beschluss vom 16. Juli 2024 (1 ABR 16/23) entschied es, dass ein Headset-System, mit dem Vorgesetzte die Kommunikation unter Beschäftigten mithören können, mitbestimmungspflichtig ist. Das gilt auch, wenn die Gespräche nicht aufgezeichnet oder gespeichert werden (BAG-Beschluss). Wie das bei einem einzelnen Beschäftigten ist, der mit seinem privaten ChatGPT-Konto eine Aufnahme hochlädt, sagt dir kein Gesetzestext. Da kommt es auf Arbeitsvertrag, Betriebsvereinbarungen und die KI-Regeln deines Arbeitgebers an. Wo der Arbeitgeber ein KI-Werkzeug einführt oder die Nutzung organisiert, steht die Betriebsratsfrage dagegen sehr wahrscheinlich im Raum. Mehr zur Betriebsrats-Seite steht in unserem Artikel zum Abschalten der KI in Teams-Meetings.
Externe und Tabuzonen. Das GDD-Konzept zur KI-Transkription von Videokonferenzen (Version 1.2, 9. Juni 2026) ist ein Verbandspapier und keine Behördenauskunft. Es zeigt aber, was Datenschutzpraktiker für tragfähig halten. Kernpunkte: Interne Teilnehmer können über eine Betriebsvereinbarung bzw. berechtigtes Interesse abgedeckt sein, externe Teilnehmer (Kunden, Dienstleister, Bewerber) brauchen vor Beginn eine aktive, dokumentierte Einwilligung („Opt-in"), und lehnt jemand ab, muss das Meeting ohne KI-Transkription laufen. Sensible Formate wie Personal- und BEM-Gespräche oder Betriebsratssitzungen sollen als „Tabu-Zonen" ganz ausgenommen werden. Bloße „Effizienz" oder „Bequemlichkeit" reiche als Zweck nicht, die Transkription müsse etwas leisten, was ein manuelles Protokoll nicht gleichwertig leistet.
Schatten-KI ist Realität. Laut Bitkom-Umfrage (604 Unternehmen ab 20 Beschäftigten, Juli und August 2025, veröffentlicht am 21. Oktober 2025) ist private KI-Nutzung im Job in 8 Prozent der Unternehmen weit verbreitet und in weiteren 17 Prozent gibt es Einzelfälle. Weitere 17 Prozent wissen es nicht sicher, gehen aber davon aus. Nur 26 Prozent der Unternehmen stellen Beschäftigten generative KI bereit, und erst 23 Prozent haben Regeln dafür aufgestellt (Bitkom). Heißt: Viele nutzen private Konten, weil es keine freigegebene Alternative gibt. Das ist verständlich, aber genau die Konstellation, in der Verantwortung, Vertrag und Speicherort offen bleiben.
Berufsgeheimnis und besondere Kategorien
Gehörst du zu den Berufsgruppen, die unter § 203 StGB fallen (Ärzte, Psychotherapeuten, Rechtsanwälte, Steuerberater und andere), ist die Lage nochmal strenger. Das ist keine DSGVO-Frage mehr, sondern Strafrecht mit eigener Logik, und ein Auftragsverarbeitungsvertrag ersetzt die Verpflichtung zur Verschwiegenheit nicht. Das haben wir ausführlich in Google Meet, KI-Notizen und § 203 StGB und im Beitrag zum KI-Diktat für die eigene Praxis beschrieben. Die Logik gilt für ChatGPT-Uploads genauso.
Wer in Aufnahmen Gesundheitsdaten, Religion oder ähnlich Sensibles verarbeitet, bewegt sich außerdem bei Art. 9 DSGVO (besondere Kategorien). Ein aktuelles Beispiel: Das Landgericht Köln hat am 17. September 2026 (Az. 33 O 120/24) in einem Verfahren des Verbraucherzentrale Bundesverbands gegen Snap zum KI-Chatbot „My AI" entschieden, dass es für Art. 9 DSGVO nicht darauf ankomme, ob der Anbieter sensible Informationen bewusst erlangen wolle (Zusammenfassung der Kanzlei Plutte). Das Urteil betrifft einen Werbekontext und ein anderes Produkt. Ich nenne es nicht, weil es ChatGPT-Audio regelt, sondern als Hinweis darauf, in welche Richtung ein Gericht gedacht hat. Ob es rechtskräftig ist, weiß ich nicht.
Übersicht: Welche Situation, welche Regel, welcher erste Schritt
| Situation | § 201 StGB | DSGVO | Dein erster Schritt |
|---|---|---|---|
| Du sprichst nur selbst (Diktat, Ideen) | Wortlaut erfasst nur das Wort „eines anderen" | Nur relevant, wenn du Namen/Daten Dritter nennst | Namen weglassen oder auf Kürzel; Training-Schalter prüfen |
| Interview mit einer Person (Journalismus, Recherche, Uni-Projekt) | Einwilligung nötig | Einwilligung; Zweck und System nennen | Ansage mit Zweck, System und Löschzeitpunkt; „Ja" auf Band |
| Kundengespräch, Telefonat, Videocall mit Externen | Einwilligung nötig | Aktive, dokumentierte Einwilligung (GDD) | Ansage vor Beginn; bei Nein: ohne KI weiter |
| Internes Meeting mit Betriebsrat im Haus | Information vorab; strittig, ob Weiterreden reicht | Betriebsvereinbarung oder berechtigtes Interesse (GDD) | Vorher Betriebsrat/Datenschutz fragen, nicht privat hochladen |
| Personalgespräch, BEM, Betriebsratssitzung | Einwilligung nötig | GDD: Tabuzone für KI-Transkription | Gar nicht aufnehmen, selbst mitschreiben |
| Gespräch mit Berufsgeheimnisträgern | Einwilligung nötig | Je nach Inhalt Art. 9 (z. B. Gesundheitsdaten), plus § 203 StGB | Beitrag zum § 203 lesen; ohne AVV und Verschwiegenheitsverpflichtung nicht hochladen |
| Vorlesung, Seminar | Je nach Einzelfall; Hochschulregeln | Je nach Aufnahme | Dozent:in fragen, schriftlich zusagen lassen |
Wie viel Skepsis ist angemessen? Zahlen aus Deutschland
Wenn du dich fragst, ob die Vorsicht übertrieben ist: Destatis hat gemessen, was Unternehmen bremst. Laut der Erhebung zur IKT-Nutzung in Unternehmen (Stand 24. November 2025) setzten 2025 26 Prozent der Unternehmen mit mindestens 10 Beschäftigten KI-Technologien ein (2024 waren es 20 Prozent, 2023 etwa 12). Bei Großunternehmen ab 250 Beschäftigten waren es 57 Prozent, bei kleinen mit 10 bis 49 Beschäftigten 23 Prozent. Von den KI-nutzenden Unternehmen setzen 42 Prozent Spracherkennung ein (Destatis, Tabelle KI-Nutzung).
Spannend ist die Gegenseite. 20 Prozent aller Unternehmen haben KI erwogen, setzen sie aber nicht ein. Von diesen nennen 72 Prozent fehlendes Wissen, 62 Prozent Unklarheit über rechtliche Folgen und 60 Prozent Bedenken hinsichtlich Datenschutz und Privatsphäre (Destatis, Gründe gegen die Nutzung). Die Kosten stehen mit 32 Prozent deutlich dahinter. Bei den Großunternehmen unter diesen Zögernden sind es sogar 63 Prozent beim Datenschutz.
Deshalb hört dieser Artikel nicht beim Feature auf: Die Hürde in Deutschland liegt selten an der Technik, sondern an fehlendem Wissen und fehlender Rechtssicherheit.
Wie genau ist das auf Deutsch?
Niemand hat bisher einen unabhängigen Vergleichstest der neuen Upload-Funktion veröffentlicht, und OpenAI sagt nicht, welches Sprachmodell dahintersteckt. Eine Genauigkeitsprozentzahl kann ich dir deshalb nicht nennen, und du solltest jedem misstrauen, der es tut. Was ich habe, ist unabhängige Evidenz zur Art der Technik, mit ihren Grenzen.
Eine begutachtete Studie von 2023 im Journal of Medical Internet Research testete 65 Zoom-Interviews in US-Englisch mit durchschnittlich 46 Minuten Länge. Die Wortfehlerrate (Anteil falscher Wörter, niedriger ist besser) lag bei 19,2 Prozent für Otters Live-Transkription, 14,8 Prozent für Whisper (OpenAIs offenes Spracherkennungsmodell), 8,9 Prozent für Amazon Transcribe und 7,6 Prozent für einen menschlichen Transkriptionsdienst. Die automatischen Dienste lagen bei Gesprächsaudio also grob bei einem falschen Wort aus fünf bis elf, der Mensch bei einem aus dreizehn. Die Lücke ist real. Ein fairer Ranking-Test heutiger Produkte ist das nicht: Die Modelle sind älter, die Sprecher Muttersprachler, Hintergrundgeräusche gab es kaum.
Für deutschsprachige Nutzer wichtiger: Keine dieser Studien testet Deutsch. Eine neuere Vorab-Veröffentlichung (GigaSpeechBench, 2026, noch nicht begutachtet) fand bei englischen Akzenten Fehlerraten von 17,1 bis 66,1 Prozent für GPT-4o Transcribe, je nach Akzent. Über Deutsch sagt sie nichts. Dialekt, Schweizerdeutsch, Mischsprache („Wir haben das Ticket gestern gecloset"), Fachvokabular und Eigennamen sind Kandidaten für Fehler. Das ist meine Einschätzung aus der Natur des Problems, keine Messung. Der pragmatische Test dauert fünf Minuten: Nimm eine Aufnahme, die du gut kennst, lad sie hoch und zähl die Fehler bei Zahlen, Namen und Zusagen.
Welcher Weg bei welchem Schutzbedarf?
Der ChatGPT-Upload ist nicht für jede Aufnahme die beste Lösung. Die Tabelle ordnet die Wege nach dem Schutzbedarf der Aufnahme, nicht nach Features.
| Weg | Was du bekommst | Datenschutz-Lage laut Quellen | Wann sinnvoll |
|---|---|---|---|
| Selbst mitschreiben | Handgeschriebenes oder getipptes Protokoll | Kein Audio, kein Drittanbieter. Das GDD nennt das manuelle Protokoll als milderes Mittel | Personalgespräche, BEM, alles Heikle |
| ChatGPT-Upload, privates Konto | Transkript, Notizen, Mail aus Datei | Kein AVV; Training hängt vom Schalter ab; Audio nicht ausdrücklich zugesichert gelöscht | Eigene Diktate, Gespräche mit Einwilligung ohne Heikles |
| ChatGPT-Upload, Business/Enterprise | Wie oben, plus Vertragsrahmen | DPA, OpenAI nutzt Inhalte nicht fürs Training (laut OpenAI); Audio nicht in der Residenz-Liste | Teams mit Freigabe von IT und Datenschutz |
| ChatGPT Record / Meetings (macOS) | Live-Mitschrift auf dem Mac | OpenAI: Audio wird nach Transkription bzw. nach den Notizen gelöscht | Wenn du Mac nutzt und live mitschreiben willst |
| Kostenlose Gemini-Route | Transkript mit Sprechertrennung | Siehe unseren Artikel: Interviews kostenlos transkribieren mit Gemini | Wenn du ein Transkript brauchst und nichts zahlen willst |
| Lokal laufende Spracherkennung (z. B. das offene Whisper-Modell auf dem eigenen Rechner) | Transkript ohne Cloud | Die Datei verlässt dein Gerät nicht | Heikle Aufnahmen, wenn du ein Transkript brauchst und etwas technisches Geschick hast |
Das Muster: Wer ohnehin ChatGPT bezahlt und für unkritische Aufnahmen „Datei rein, Notizen raus" will, spart mit dem Upload womöglich ein zusätzliches Abo. Wer jeden Zoom-Call automatisch erfasst haben will, mit Namen und durchsuchbarem Archiv, kommt mit einem dedizierten Meeting-Tool weiter. Und bei heiklen Gesprächen bleibt der Stift die schärfste Datenschutz-Lösung.
Zu Preisen der Wettbewerber: Die OpenAI-API für Speech-to-Text kostet bei GPT-4o Transcribe etwa 0,006 US-Dollar pro Minute (rund 0,36 Dollar pro Stunde); Otter und Fathom bieten kostenlose Stufen (siehe Otter und Fathom, US-Dollar-Preise, ohne Gewähr). Für Deutschland zählt aber weniger der Preis als die Frage nach Vertrag und Speicherort.
Was das für dich bedeutet
Wenn du angestellt bist (mit oder ohne Betriebsrat): Kennst du die KI-Regel deines Arbeitgebers? Laut Bitkom haben erst 23 Prozent der Unternehmen überhaupt eine. Frag also, bevor du etwas hochlädst. „Keine Regel" ist kein Freibrief, sondern eine Lücke, in der du das Risiko selbst trägst. Gibt es einen Betriebsrat, hol ihn dazu, bevor du ein Team-Tool für Aufnahmen einführst: § 87 Abs. 1 Nr. 6 BetrVG und die weite Auslegung durch das BAG sprechen dafür, dass er mitbestimmt. Erste Aktion diese Woche: Schick deiner Führungskraft oder dem Datenschutzbeauftragten zwei Sätze: „Darf ich Gesprächsaufnahmen mit Einwilligung der Beteiligten in ChatGPT zu Notizen verarbeiten? Wenn nein, welches Werkzeug ist freigegeben?" Die Antwort (oder das Schweigen) hast du dann schriftlich.
Wenn du selbstständig oder Freelancer bist: Du bist Verantwortliche:r und brauchst dafür eine Rechtsgrundlage und einen Einwilligungsnachweis, aber keinen Betriebsrat. Der größte Zeitgewinn ist die 60-Sekunden-Sprachmemo nach jedem Kundentermin, die du in eine Follow-up-Mail verwandelst. Erste Aktion: Nimm nach dem nächsten Termin eine Memo mit deiner eigenen Stimme auf (ohne Klarnamen der Kundschaft), lad sie hoch und sieh dir an, wie gut das Ergebnis ist. Das ist rechtlich der einfachste Einstieg, auch wenn Datenschutzfragen bleiben, sobald der Inhalt auf Kundschaft schließen lässt.
Wenn du Journalist:in oder Podcaster:in bist: Interviews sind der klassische Fall: Einwilligung der Gesprächspartner:in, Zweck nennen, Löschzeitpunkt nennen. Nach § 201 Abs. 2 Satz 1 Nr. 2 StGB ist das öffentliche Mitteilen unbefugt aufgenommener Gespräche strafbar, wenn es geeignet ist, berechtigte Interessen eines anderen zu beeinträchtigen (nicht rechtswidrig bei überragenden öffentlichen Interessen, Satz 3). Erste Aktion: Bau dir eine Standard-Ansage für den Interviewbeginn und gib sie in jedem Interview an derselben Stelle ab, am besten vor dem ersten inhaltlichen Wort. Kritische Quellen: lieber lokal transkribieren oder selbst abtippen.
Wenn du studierst: Frag vor der Aufnahme von Vorlesungen die Lehrenden und achte auf die Regeln deiner Hochschule. Wenn es erlaubt ist, kann der Upload Mitschriften ersetzen: Hauptbegriffe, drei Übungsfragen, Glossar. Erste Aktion: Probier es an einer kurzen, erlaubten Aufnahme aus und gleich danach die Ergebnisse mit den Folien ab. Das Free-Konto reicht dafür nicht, ein bezahlter Tarif ist nötig.
Wenn du unter Berufsgeheimnis stehst (Ärzt:in, Therapeut:in, Rechtsanwält:in, Steuerberater:in): Wer ohne die nötige vertragliche Absicherung hochlädt, bewegt sich nicht nur im Datenschutzrecht, sondern im Strafrecht. Erste Aktion: Lies unseren Beitrag zu § 203 StGB und KI-Notizen, und lade bis zur Klärung mit Datenschutzbeauftragten oder Kammer nichts hoch.
Wenn du Geschäftsführer:in im Mittelstand bist: Dein Betrieb hat womöglich Schatten-KI, ob du es weißt oder nicht (Bitkom: 8 Prozent „weit verbreitet", 17 Prozent „Einzelfälle", 17 Prozent „vermutlich"). Statt zu verbieten, gib einen freigegebenen Weg vor. Erste Aktion: Setz dich mit dem Datenschutzbeauftragten und (falls vorhanden) dem Betriebsrat zusammen und legt gemeinsam fest, welche Gespräche mit KI verarbeitet werden dürfen, welche nie, und wo die Dateien landen.
Wenn du im Free-Tarif bist: Audio-Uploads gibt es für dich derzeit nicht. Nutz die Sprachfunktion zum Diktieren, oder transkribier zuerst mit einem kostenlosen Werkzeug und lass den Text in ChatGPT zusammenfassen (einen Weg zeigt der Artikel zur kostenlosen Gemini-Transkription). Erste Aktion: Prüf, ob du den Funktionsumfang wirklich brauchst, bevor du ein Abo abschließt. Beim Vergleich hilft unser Artikel zu den ChatGPT-Tarifen.
Grenzfälle und Problembehandlung
Ich trenne, was OpenAI dokumentiert, von dem, was aus der Technik oder dem Recht wahrscheinlich folgt. Erste Praxisberichte sind dünn, die Liste wird wachsen.
1. „Die Datei wird abgelehnt, obwohl sie abspielbar ist." (Dokumentiert.) Meist ist es ein MP4 oder WebM, das als Video erkannt wird, typisch bei Teams- oder Zoom-Aufzeichnungen. Exportier die Tonspur als MP3 oder M4A und versuch es nochmal. Prüf außerdem, ob die Datei beschädigt ist.
2. „Es heißt, ich hätte das Upload-Limit erreicht." (Dokumentiert.) Laut OpenAI: richtiges Konto und Tarif prüfen, Rate-Limit und Speicher kontrollieren, und bedenken, dass fehlgeschlagene Versuche aufs Limit angerechnet werden können. Wart ab, bevor du dieselbe Datei wiederholt hochlädst.
3. „Das Transkript bricht mitten in einer langen Aufnahme ab." (Dokumentierte Warnung, wahrscheinliche Ursache.) Zerleg die Datei in kürzere Teile, einen pro Thema oder pro Stunde, und verarbeite sie einzeln.
4. „Sprecher sind vertauscht oder falsch benannt." (Dokumentiert.) OpenAI schreibt, die Sprecheridentifikation könne unzuverlässig sein. Nenn die Namen im Prompt („Es sprechen drei Personen: Frau Becker vom Kunden, Herr Aydın vom Vertrieb und ich") und prüf Zusagen gegen den Ton. Beachte bei Zusatzdiensten außerdem: Das GDD-Konzept warnt vor Werkzeugen, die Stimmprofile zur Wiedererkennung anlegen, weil das nach Art. 9 DSGVO biometrische Daten sein können. Dass OpenAI das bei Uploads tut, ist mir nicht bekannt.
5. „Eine Zahl, ein Datum, ein Name stimmt nicht, oder Dialekt und Denglisch gehen schief." (Wahrscheinlich, und der Grund für Schritt 4.) Spracherkennung macht bei Namen, Zahlen, Adressen und Fachbegriffen erfahrungsgemäß mehr Fehler. Lass das Modell unsichere Stellen markieren, rechne Beträge gegen (siehe Beispiel oben) und teste vor einer langen Aufnahme eine kurze Probe in deiner Sprachfärbung. Ein näheres Mikrofon in einem ruhigen Raum hilft mehr als jeder Prompt.
6. „Eine Teilnehmerin widerruft nach dem Upload ihre Einwilligung." (Aus dem GDD-Papier abgeleitet.) Laut GDD wirkt ein Widerruf für die Zukunft, die weitere Nutzung der betreffenden Aufnahmen und Transkripte ist dann untersagt, und die Daten müssen unverzüglich gelöscht werden. In ChatGPT heißt das praktisch: Lösch den Chat und die gespeicherte Datei in Library bzw. Space. Ob sich eine Nutzung zu Trainingszwecken, falls der Schalter an war, rückgängig machen lässt, habe ich nicht geprüft. Dazu steht im Upload-Artikel nichts. Außerdem können Betroffene laut GDD jederzeit Zugang zu bestehenden Aufzeichnungen und Transkripten verlangen. Kurze Löschfristen ersparen dir beides.
7. „Ich habe den Chat gelöscht, aber die Datei ist noch da." (Dokumentiert, siehe Schritt 6.) Entferne die Kopie in der Library. In manchen Workspaces gibt es einen Bereich „Zuletzt gelöscht", aus dem Dateien wiederherstellbar sind, bis du sie endgültig löschst. Leere ihn, wenn die Datei wirklich weg sein soll.
8. „Ich bin im bezahlten Tarif und sehe die Option nicht." (Dokumentiert: Die Verfügbarkeit hängt von Workspace, Region, App-Version und Modell ab.) Aktualisiere die App, probier die Web-Version, und frag den Admin, falls du in einem Business- oder Enterprise-Workspace bist.
Was die Funktion nicht kann
Sie macht keine schlechte Aufnahme gut. Übersprechen, Wind, ein Handy am anderen Tischende und ein vom Mikrofon abgewandter Sprecher senken die Genauigkeit, und kein Prompt repariert das.
Sie garantiert nicht, wer was gesagt hat. Ein Transkript ist ein Entwurf, kein Protokoll, das du einem Gericht oder einer Behörde hinlegen würdest. Die heise-Runde formuliert den Punkt so: KI-Zusammenfassungen interpretierten, statt wörtlich zu protokollieren, und wer ungeprüfte Zusammenfassungen weitergibt, trägt die Verantwortung für deren Fehler.
Sie nimmt dir die Einwilligungspflicht nicht ab. OpenAIs eigene Seiten legen die Verantwortung bei dir. Beim Meetings-Plugin steht, du sollst allen im Meeting sagen, dass du Notizen machst, und ihr Einverständnis einholen. Die Erinnerung in der App sei nur für dich sichtbar und informiere die anderen Teilnehmer nicht. Bei Record steht sinngemäß: Prüf die lokalen Gesetze und hol die richtigen Einwilligungen ein.
Sie verspricht keine Löschung. Anders als beim Meetings-Plugin, wo OpenAI zusagt, dass das Audio nach den fertigen Notizen gelöscht wird, steht im Hilfeartikel zu Uploads keine entsprechende Zusage. Hochgeladenes Audio ist eine Datei in deinem Konto, bis du sie löschst.
Häufige Fragen
Kann ChatGPT jetzt Audio transkribieren? Ja, in bezahlten Tarifen und Workspaces, seit dem 6. Oktober. Du hängst eine Audiodatei an einen Chat und forderst Transkript, Zusammenfassung, Notizen oder eine Follow-up-Mail an. Im Free-Tarif ist die Funktion laut OpenAI „zu diesem Zeitpunkt" nicht verfügbar.
Wie groß darf die Audiodatei sein? Gilt das 25-MB-Limit noch? In ChatGPT bis zu 512 MB pro Datei. Die 25 MB, die auf vielen deutschen Seiten stehen, gehören zur separaten Entwickler-API von OpenAI. Sehr lange Aufnahmen werden laut OpenAI nur „best-effort" verarbeitet und können in einen Timeout laufen.
Nutzt ChatGPT dafür Whisper? Das behaupten mehrere deutsche Anbieterseiten. OpenAI nennt in seinen Hilfeseiten zu den Uploads kein Modell. Als belegte Tatsache kannst du es also nicht weitergeben.
Darf ich ein Gespräch aufnehmen, um es von ChatGPT auswerten zu lassen? In der Regel nur mit Einwilligung der Gesprächspartner. § 201 StGB stellt die unbefugte Aufnahme des nichtöffentlich gesprochenen Worts eines anderen unter Strafe (bis zu drei Jahre Freiheitsstrafe oder Geldstrafe). Datenschutzrechtlich brauchst du zusätzlich eine Rechtsgrundlage, in der Praxis meist die Einwilligung. Sag vorher, dass du aufnimmst, wofür und mit welchem Dienst, und warte auf das „Ja".
Reicht es, wenn alle weiterreden, nachdem ich Bescheid gesagt habe? Die Meinungen gehen auseinander: Das GDD hält strafrechtlich eine konkludente Zustimmung für ausreichend, datenschutzrechtlich nicht, die heise-Runde „wer bleibt, willigt ein" generell für nicht tragfähig. Sicherer ist eine ausdrückliche Zustimmung, die du auf der Aufnahme festhältst.
Ist ChatGPT DSGVO-konform? Das lässt sich pauschal nicht beantworten. Es hängt vom Tarif (Verbraucher- oder Geschäftsvertrag), deinen Einstellungen, deiner Rechtsgrundlage und dem Inhalt der Aufnahme ab. OpenAI Ireland Limited ist für EWR-Nutzer Verantwortliche und nennt Standardvertragsklauseln für Drittlandübermittlungen. Ob das für dein Szenario reicht, klärst du mit deinem Datenschutzbeauftragten, nicht mit einem Blogartikel.
Wird meine Aufnahme zum Training von ChatGPT verwendet? Das hängt laut OpenAI vom Dienst und von deinen Datenkontroll-Einstellungen ab. Prüf auf privaten Konten, ob „Das Modell für alle verbessern" aktiviert ist, bevor du Stimmen anderer hochlädst. Für Business-Angebote wie API und Enterprise sagt OpenAI, Kundeninhalte würden nicht zum Training genutzt.
Muss ich den Betriebsrat fragen? Wenn dein Arbeitgeber ein solches Werkzeug einführt oder die Nutzung organisiert, spricht die weite Auslegung von § 87 Abs. 1 Nr. 6 BetrVG durch das BAG dafür, dass der Betriebsrat mitbestimmt. Für die private Einzelnutzung eines Beschäftigten gibt es keine pauschale Antwort. Frag Betriebsrat oder Datenschutzbeauftragte und lass dir die Regeln schriftlich bestätigen.
Darf ich meine eigene Sprachmemo hochladen? Nach dem Wortlaut ist das strafrechtlich unproblematisch, weil § 201 StGB das Wort „eines anderen" schützt. Datenschutzrechtlich wird es relevant, sobald du Namen oder Daten anderer Personen nennst, vor allem im beruflichen Kontext.
Unterm Strich
Der Upload ist eine Verbesserung, aber bescheidener, als „ChatGPT kann jetzt alles transkribieren" klingt. Er gilt nur für bezahlte Tarife, nimmt die gängigen Audioformate bis 512 MB, verarbeitet sehr lange Dateien nur nach bestem Bemühen, und OpenAI warnt selbst vor Fehlern im Transkript und wackligen Sprecherlabels. Die vernünftige Nutzung ist unspektakulär: mit Einwilligung aufnehmen, eine Datei pro Chat hochladen, eine konkrete Struktur verlangen, Namen, Zahlen und Zusagen gegen den Ton prüfen und heikle Dateien danach löschen. Für Deutschland kommt eine Ebene dazu, die viele Anleitungen auslassen: Ob du darfst, ist die schwierigere Frage als die, ob die Technik es kann. Die Destatis-Zahlen zeigen, dass das nicht nur dein Gefühl ist: Datenschutz und rechtliche Unsicherheit gehören zu den meistgenannten Bremsen für KI im Betrieb.
Wenn du daraus eine verlässliche Routine machen willst, hilft dir unser Kurs KI-Meeting-Notizen mit Prompts und Prüfschritten für klare nächste Schritte. KI-Meeting-Protokolle, die brauchbar sind behandelt die rote Linie bei Aufnahme und Datenschutz (§ 201 StGB, DSGVO, Betriebsrat), und Datenschutz im Arbeitsalltag mit KI ordnet ein, was du in Prompts besser nicht sendest. Für ChatGPT insgesamt ist der ChatGPT Meisterkurs der breitere Einstieg.
Quellen
Aus Deutschland
- Gesetze im Internet: § 201 StGB, Verletzung der Vertraulichkeit des Wortes
- Gesetze im Internet: § 26 BDSG, Datenverarbeitung für Zwecke des Beschäftigungsverhältnisses
- Gesetze im Internet: § 87 BetrVG, Mitbestimmungsrechte
- Bundesarbeitsgericht, Beschluss vom 16. Juli 2024, 1 ABR 16/23 (Headset-System, § 87 Abs. 1 Nr. 6 BetrVG)
- GDD-Kurzpapier 4: Gesprächstranskription (Stand Januar 2026)
- GDD: KI-gestützte Transkription von Videokonferenzen, Gesamtkonzept, Version 1.2 (9. Juni 2026)
- Datenschutzkonferenz: Orientierungshilfe „Künstliche Intelligenz und Datenschutz" (Mai 2024)
- Datenschutzkonferenz: Pressemitteilung zur Orientierungshilfe KI (6. Mai 2024)
- heise c’t: Auslegungssache 169, Datenschutz in Videokonferenzen (2. Oktober 2026)
- Destatis: Unternehmen mit Nutzung von KI-Technologien nach Größenklassen 2025
- Destatis: Gründe gegen die Nutzung von KI-Technologien 2025
- Bitkom: „Beschäftigte nutzen vermehrt Schatten-KI" (21. Oktober 2025)
- Heuking: EuG bestätigt Wirksamkeit des EU-US Data Privacy Framework
- Kanzlei Plutte: LG Köln zu sensiblen Daten in KI-Chatbots (17. September 2026)
- DSGVO, Art. 2 (Anwendungsbereich), Text der Verordnung
- Transkriptor: Kann ChatGPT Audio transkribieren? (3. April 2026), als Beispiel für veraltete Angaben
- VexaScribe: ChatGPT Audio transkribieren (Verifiziert 15. August 2026), als Beispiel für veraltete Angaben
Von OpenAI
- OpenAI Help Center: ChatGPT Release Notes (6. Oktober 2026: Audio uploads in ChatGPT)
- OpenAI Help Center: Uploading files and audio to ChatGPT
- OpenAI Help Center: The Meetings plugin in ChatGPT
- OpenAI Help Center: ChatGPT Record
- OpenAI Help Center: Data residency and inference residency for ChatGPT
- OpenAI: Europe privacy policy
- OpenAI: Data Processing Addendum
- OpenAI API-Dokumentation: Speech-to-text (25-MB-Limit der API)
Studien und Übriges