„Danke, EU!" Mit diesem Satz hat am Montagabend ein X-Nutzer die Nachricht kommentiert, die seit gestern durch die deutschsprachige Tech-Presse läuft: OpenAI will ChatGPT- und Codex-Texte in der EU künftig mit einem unsichtbaren Wasserzeichen versehen. Der Name der Technik: textGrain. Ein anderer sprach von „Brüssel simuliert Transparenz", und Schmidtis Blog nannte das Ganze ein Feigenblatt. Und unter vielen Posts steht dieselbe Frage: Betrifft mich das jetzt, und kann man mich damit erwischen?
Die ehrliche Antwort hat zwei Teile. Ja, wenn du ChatGPT aus Deutschland oder Österreich nutzt, gehörst du zur ersten Gruppe, die das Wasserzeichen bekommt. (Die Schweiz ist nicht in der EU. OpenAI spricht ausdrücklich nur von der EU, zur Schweiz hat das Unternehmen nichts gesagt.) Und nein, erwischen kann man dich damit erstaunlich schlecht. OpenAI hat die Schwächen nämlich selbst veröffentlicht, mit Zahlen. Die schauen wir uns jetzt mal genauer an.
Dafür hab’ ich OpenAIs Ankündigung und den Help-Center-Artikel gelesen. Dazu hab’ ich die Berichterstattung von the-decoder.de, winfuture, all-ai und Schmidtis Blog, die Erklärung der Computerwoche zur KI-Kennzeichnungspflicht, die Bitkom-Umfrage zur KI-Nutzung und die deutschsprachigen Reaktionen auf X ausgewertet. Was bestätigt ist, sage ich dir. Was OpenAI bisher nicht verraten hat (und das ist einiges), sage ich auch, denn ein erheblicher Teil dessen, was gerade kursiert, ist schlicht geraten.
Was textGrain eigentlich ist
Ein Text-Wasserzeichen klingt nach etwas, das man sehen oder markieren kann. textGrain ist das nicht. OpenAI beschreibt es im Help Center als „eine unsichtbare Änderung an der Zufälligkeit, mit der das Modell seine Wörter auswählt".
Die Kurzfassung: Wenn ChatGPT einen Satz schreibt, entscheidet es ständig zwischen Wörtern, die alle passen würden. „Beginnen" oder „starten", „groß" oder „riesig", „aber" oder „doch". Meistens ist das eben fast ein Münzwurf. textGrain lenkt diese Münzwürfe mit einem geheimen Schlüssel. Über ein paar hundert Wörter entsteht so ein statistisches Muster. Ein Detektor, der den Schlüssel kennt, kann danach suchen. Du als Leser:in siehst einfach normalen Text.
Daraus ergeben sich drei Konsequenzen, und die erklären eigentlich alles Weitere:
- Das Zeichen steckt in der Wortwahl, nicht in versteckten Zeichen. Laut Help Center fügt textGrain keine versteckten Zeichen, unsichtbaren Leerzeichen oder ungewöhnliche Satzzeichen ein. Kopieren und Einfügen in Word oder Google Docs entfernt es also nicht, und ein „Unsichtbare Zeichen entfernen"-Tool bringt gar nichts. (Das hat übrigens früher mal anders ausgesehen: 2025 gab es Berichte über Sonderzeichen in ChatGPT-Texten. Das war ein anderes, simples Verfahren und hat mit textGrain nichts zu tun.)
- Es braucht Länge. Ein einzelner Satz hat halt zu wenige Wortentscheidungen, um ein Muster zu bilden. Ein paar hundert Wörter reichen.
- Wer die Wörter ändert, ändert die Beweislage. Schreibst du den Text um, ersetzt du genau die Entscheidungen, aus denen das Muster besteht.
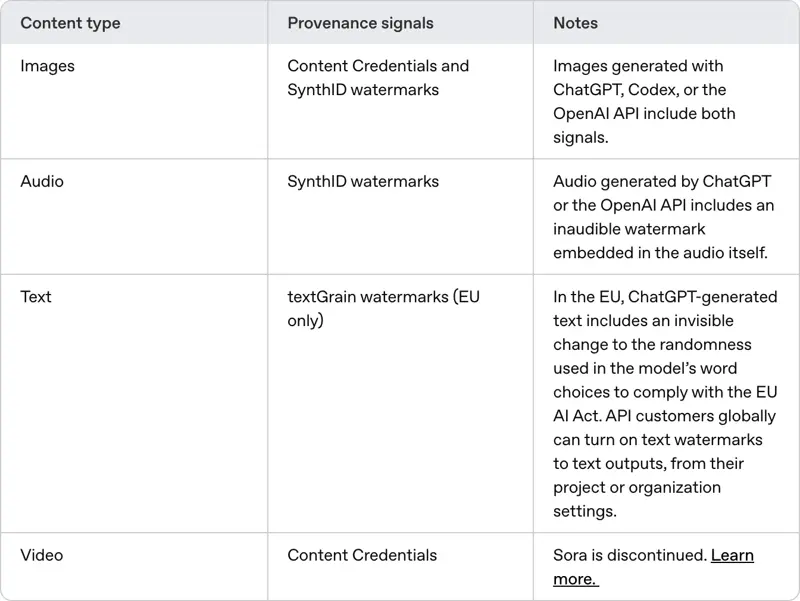
Bei Bildern und Audio setzt OpenAI schon länger auf Wasserzeichen (SynthID von Google DeepMind) und Content Credentials. Text ist ja neu, und er ist der erste Fall, bei dem der Detektor bewusst nicht öffentlich ist.
Was OpenAI am 5. Oktober angekündigt hat
Alles in der folgenden Tabelle stammt aus OpenAIs eigener Ankündigung und dem Help-Center-Artikel. TechCrunch und the-decoder.de bestätigen die Zahlen.
| Frage | Was OpenAI sagt |
|---|---|
| Wer bekommt standardmäßig markierte Texte? | „Eligible ChatGPT and Codex text output in the European Union", über alle Tarife |
| Wann? | „Over the coming weeks". Ein genaues Datum gibt’s nicht, in deinem Konto ist es vielleicht noch gar nicht aktiv |
| Gilt das weltweit? | Nein. OpenAI macht Wasserzeichen „nicht zum globalen Standard beim Start" |
| Und die API? | Entwickler weltweit können es ab dem 5. Oktober für „select models" einschalten. Standardmäßig aus |
| Wo schaltet man es in der API ein? | In den Projekt- oder Organisationseinstellungen (laut Help Center) |
| Kann ich Text prüfen lassen? | Nicht öffentlich. Detektor-Zugang nur für „approved researchers and expert organizations" |
| Identifiziert es mich? | Nein. OpenAI sagt, es verknüpft Text weder mit Person, Konto, Prompt noch Unterhaltung |
| Schadet es der Qualität? | OpenAI meldet keinen nennenswerten Unterschied in seinen Benchmarks |
| Wird es Open Source? | OpenAI will die Technik quelloffen machen, ohne Termin |
| Warum jetzt? | Transparenzpflichten des EU AI Act, seit 2. August 2026 anwendbar |
Ein paar Punkte, bei denen ich kurz hängenbleibe.
In der EU ja, sonst nein. OpenAIs Formulierung lautet, man mache Text-Wasserzeichen „nicht zum globalen Standard beim Start" und der regionale Ansatz gebe „Raum, aus echter Nutzung zu lernen". Wer ChatGPT aus den USA nutzt, steht laut Ankündigung eben nicht im Standard-Rollout. Eine Ausnahme: Texte aus Apps, die per API auf OpenAI aufbauen und deren Entwickler das Wasserzeichen aktiviert haben.
Der Detektor ist kein Produkt. OpenAI nimmt Bewerbungen von Forschenden und Organisationen an, die bei der Bewertung helfen. Als Partner nennt das Help Center unter anderem John Thickstun (Cornell), Martin Vechev (ETH Zürich und INSAIT) und das Kempelen Institute. Eine Lehrkraft, eine Redaktion, eine Personalabteilung oder du selbst kannst heute eben nichts prüfen. Alles, was dir im Netz als „ChatGPT-Wasserzeichen-Checker" angeboten wird, kann OpenAIs Detektor gar nicht nutzen.
OpenAI hat die Schwachstellen selbst veröffentlicht. Das ist ungewöhnlich, und ich find’, das verdient erst mal Anerkennung. Es heißt aber auch: Wir müssen ja nicht raten, wie fragil das Zeichen ist.
Wie gut funktioniert das? OpenAIs eigene Zahlen
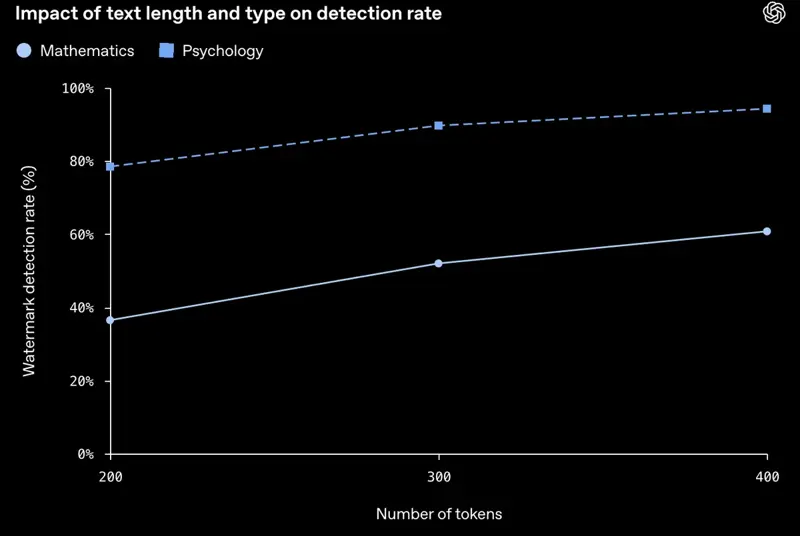
OpenAI hat textGrain bei einer Ziel-Falsch-Positiv-Rate von 1 Prozent getestet. Das heißt: Der Detektor ist eben so eingestellt, dass er unmarkierten Text in etwa einem von hundert Fällen fälschlich markiert. Bei dieser Einstellung gilt:
- Bei Texten über Psychologie wurden rund 95 Prozent der Passagen mit 400 Token erkannt (grob 300 Wörter).
- Bei 200 Token (grob 150 Wörter) waren es rund 80 Prozent.
- Bei Mathematik, wo es ja kaum Spielraum bei der Wortwahl gibt, liegt die Erkennung „deutlich niedriger". Auf OpenAIs Grafik lese ich grob 37 Prozent bei 200 Token und grob 61 Prozent bei 400 Token ab.
Und jetzt der Teil, der für alle zählt, die ihre Texte überarbeiten (also fast alle, hand aufs Herz). Bei Passagen mit 400 Token:
- Unverändert: etwa 92 Prozent erkannt.
- 10 Prozent der Wörter durch Synonyme ersetzt: Erkennung sinkt auf etwa 66 Prozent.
- 25 Prozent der Wörter ersetzt: Erkennung sinkt auf etwa 17 Prozent.
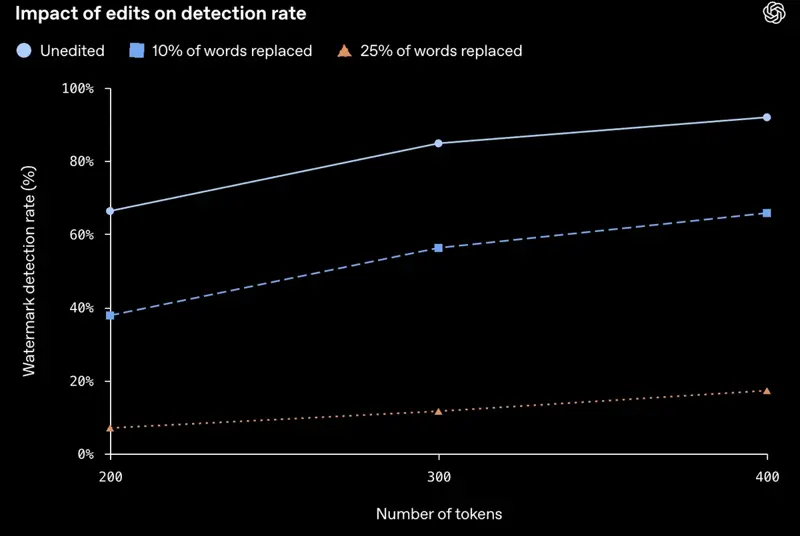
Übersetzte Texte sind laut OpenAI ebenfalls schwerer zu erkennen, und umfangreiches Umschreiben kann das Zeichen unauffindbar machen. Eine Zahl für Übersetzungen nennt OpenAI nicht. (Falls du dich fragst, warum das für uns relevant ist: Wer im deutschsprachigen Raum mit ChatGPT übersetzt oder von Englisch nach Deutsch umschreibt, ist ja genau in diesem Graubereich.)
Zur Qualität: OpenAI hat sein neuestes Modell (Astra) mit und ohne Wasserzeichen verglichen. Der Artificial-Analysis-Intelligence-Index liegt bei 49,57 Punkten ohne und 49,76 mit Wasserzeichen. GPQA Diamond: 94,44 gegenüber 93,94 Prozent. BrowseComp: 87,92 gegenüber 87,35 Prozent. Die Abweichungen gehen in beide Richtungen. So sieht „kein nennenswerter Unterschied" in der Praxis eben aus. Das ist übrigens auch die Antwort auf die Sorge, die in den deutschen Kommentaren am häufigsten auftaucht: „Niemand wird den Einfluss auf die Qualität messen." Doch, OpenAI hat es zumindest für Benchmarks gemessen. Ob das auch für deinen Alltagstext stimmt, ist natürlich eine andere Frage.
Eine Behauptung wird sicher noch oft zu lesen sein: In OpenAIs eigenen Tests habe textGrain andere Verfahren erreicht oder übertroffen, auch SynthID für Text. Das ist OpenAIs eigene Auswertung. Eine unabhängige Prüfung gab es am Tag nach der Ankündigung noch nicht.
Das Rechenbeispiel: Ein Anschreiben, vier Szenarien
Tja, Prozentzahlen sind rutschig. Deshalb nehmen wir ein konkretes Dokument: ein Bewerbungsanschreiben mit 300 Wörtern. Als Faustregel entspricht ein Token etwa drei Vierteln eines Wortes, also sind das ungefähr 400 Token, genau die Größe, die OpenAI getestet hat.
Szenario A: Du übernimmst den ChatGPT-Entwurf unverändert. In OpenAIs Test würde ein Detektor etwa 92 von 100 solcher Passagen erkennen. Wenn jemand einen Detektor hätte (was fast niemand hat), wäre die Trefferchance ja hoch.
Szenario B: Du tauschst jedes zehnte Wort. Bei 300 Wörtern sind das rund 30. Die Erkennung sinkt auf etwa 66 von 100. Du hast ordentlich gearbeitet, und das Signal ist trotzdem eher da als nicht da.
Szenario C: Du schreibst jedes vierte Wort um. Rund 75 Wörter. Die Erkennung sinkt auf etwa 17 von 100. Die meisten, die „das klingt jetzt wie ich" hinbekommen wollen, ändern ja mindestens so viel.
Szenario D: Du schreibst den Text selbst und lässt ChatGPT nur drei Kommas korrigieren. Hier gelten die Schlagzeilenzahlen gar nicht. Das Modell hat deinen Text mit leichten Änderungen zurückgegeben, also stammt kaum etwas von seinen Zufallsentscheidungen. OpenAIs Help Center sagt ausdrücklich, ein Wasserzeichen zeige nicht, wie stark ein Modell beteiligt war. Es kann nahelegen, dass ein Modell Text verarbeitet hat. Wer dabei gedacht hat, zeigt es eben nicht.
Jetzt die Kehrseite, und die betrifft vor allem Hochschulen. Der Detektor ist so eingestellt, dass er unmarkierten Text in etwa einem Prozent der Fälle falsch markiert. Würde eine Hochschule 300 selbst geschriebene Hausarbeiten durch einen solchen Detektor schicken, wären etwa drei Fehlalarme zu erwarten (1 Prozent von 300). Drei Studierende, denen etwas unterstellt wird, das sie nicht getan haben. Das ist einer der Gründe, warum OpenAI den Detektor „angesichts des Risikos verpasster Wasserzeichen und falscher Treffer" nicht öffentlich macht. Und es ist der Grund, warum ein Treffer niemals als Beweis taugen sollte.
Betrifft es mich? Der Schritt-für-Schritt-Check
Es gibt keinen Prüfer. „Bin ich markiert?" heißt also eigentlich: „Könnte ich markiert sein?" So gehst du vor.
Schritt 1: Wo wurde der Text erzeugt?
- Über ChatGPT oder Codex mit einem Konto, das du in der EU nutzt: Das ist die Gruppe, die laut OpenAI „in den kommenden Wochen" markiert wird.
- Über ChatGPT von außerhalb der EU: Dafür hat OpenAI keinen Standard-Rollout angekündigt.
- Über eine App oder Website, die auf der OpenAI-API aufbaut: nur markiert, wenn die Entwickler es eingeschaltet haben, und nur bei „ausgewählten Modellen".
- Über Claude, Gemini oder ein anderes Tool: andere Regeln. Anthropic markiert Claude weltweit auf unterstützten neuen Modellen (mehr dazu in unserem Beitrag Claude-Wasserzeichen vs. KI-Detektor), und Googles SynthID steckt schon in Gemini.
Schritt 2: Der Zeitpunkt. OpenAI sagt „in den kommenden Wochen", nicht „heute". Texte aus der Zeit, bevor der Rollout dein Konto erreicht hat, sind nicht markiert. OpenAI sagt außerdem ausdrücklich: Was vor dem Wasserzeichen entstanden ist, lässt sich nicht erkennen.
Schritt 3: Die Länge. Unter 100 bis 150 Wörtern gibt es eben oft zu wenig Signal. Ab 300 Wörtern unveränderter Modellausgabe ist dagegen reichlich Signal vorhanden.
Schritt 4: Wie viel hast du geändert? Wenn mehr als ein Viertel der Wörter von dir stammt, würde ein Detektor laut OpenAI nur noch etwa in einem von sechs Fällen anschlagen. Hast du nur Satzzeichen angefasst, ist praktisch alles unverändert.
Schritt 5: Die VPN-Frage. Die stellen gerade viele („Dass es mit VPN kein Wasserzeichen gibt, ist noch nicht sicher", schrieb jemand treffend). OpenAI hat nicht gesagt, wie es entscheidet, wer als EU-Nutzer:in gilt: nach IP, nach Konto, nach Abrechnungsland? Die einzigen Antworten, die kursieren, sind halt Vermutungen, auch die eines KI-Chatbots. Plane nicht damit. Und selbst wenn es funktionieren würde: OpenAI kündigt an, jeden Teil des Ansatzes zu überprüfen, und deine Hochschule oder dein Arbeitgeber fragt sowieso nicht nach deiner IP-Adresse.
Schritt 6: Vergiss Prüfseiten. Eine Website, die dir verspricht, deinen Text auf das „ChatGPT-Wasserzeichen" zu prüfen, kann OpenAIs Detektor nicht nutzen. Das ist ein Klassifikator, der rät, oder eine Seite, die an deine Daten will. Gib dort keine vertraulichen Texte ein.
Warum die EU, und was das Gesetz wirklich verlangt
Der Anlass ist eigentlich nur ein einziger Artikel im EU AI Act. Artikel 50 Absatz 2 verpflichtet Anbieter generativer KI-Systeme, synthetische Ausgaben (Text, Bild, Audio, Video) maschinenlesbar zu kennzeichnen. Seit dem 2. August 2026 gilt Artikel 50 grundsätzlich. Eine Ausnahme gibt es für Systeme, die lediglich „Standard-Assistenzbearbeitung" leisten oder die Eingabe nicht wesentlich verändern. Deshalb ist Text, den du selbst geschrieben und nur leicht glätten lassen hast, eben eine Grauzone.
Für die Aufsicht ist in Deutschland die Bundesnetzagentur zuständig (über das begleitende Gesetz, das KI-MIG). Laut Computerwoche drohen bei Verstößen Bußgelder bis zu 15 Millionen Euro oder drei Prozent des weltweiten Jahresumsatzes. Dazu können auch Mitbewerber und Verbraucherschutzorganisationen wettbewerbsrechtlich vorgehen, etwa per Abmahnung. Wichtig: Das richtet sich an die Anbieter und an Unternehmen, die KI-Texte veröffentlichen. Als Privatperson, die ChatGPT nutzt, bist du nicht der Adressat.
Zwei Daten solltest du kennen:
- 2. August 2026: Artikel 50 gilt. Neue Systeme sollten gleich mit Kennzeichnung starten. Deshalb hat Anthropic an diesem Tag sein Claude-Wasserzeichen eingeschaltet.
- 2. Dezember 2026: Das Ende einer viermonatigen Übergangsfrist für die maschinenlesbare Kennzeichnung. Das Digital-Omnibus-Paket sieht sie für Systeme vor, die schon vor dem 2. August am Markt waren. Das erklärt ja, warum OpenAI textGrain „über die kommenden Wochen" ausrollt statt über Nacht.
Dazu kommt ein freiwilliger Verhaltenskodex für die Transparenz KI-generierter Inhalte, den die EU-Kommission am 10. Juni 2026 veröffentlicht hat. Auf der ersten Unterzeichnerliste vom 31. Juli standen rund 190 Organisationen, darunter OpenAI, Anthropic, Google, Microsoft, Meta und Mistral. OpenAI schreibt im Help Center, das Text-Wasserzeichen entspreche den Zusagen aus diesem Kodex.
Zwei Dinge macht das Gesetz nicht. Es verlangt eben kein sichtbares „von KI geschrieben"-Banner auf jedem KI-gestützten Dokument. Und es macht aus einem Wasserzeichen-Treffer keinen juristischen Beweis dafür, dass jemand geschummelt hat. Beim Veröffentlichen von KI-Texten zu Themen von öffentlichem Interesse kann zwar eine Offenlegungspflicht greifen. Laut Computerwoche entfällt sie aber, wenn ein Mensch den Text vor der Veröffentlichung geprüft hat und jemand die redaktionelle Verantwortung übernimmt.
textGrain, Claude und Gemini im Vergleich
Alle drei großen Assistenten nutzen inzwischen ja eine Variante derselben Grundidee. Sie unterscheiden sich aber darin, wen es betrifft und wer prüfen kann.
| OpenAI (ChatGPT, Codex) | Anthropic (Claude) | Google (Gemini) | |
|---|---|---|---|
| Verfahren | textGrain (statistisches Wasserzeichen in der Wortwahl) | Variante von Googles SynthID-Text, laut Anthropic | SynthID-Text |
| Wo es gilt | ChatGPT und Codex in der EU, „in den kommenden Wochen"; API-Opt-in weltweit | Unterstützte neue Claude-Modelle, weltweit, seit 2. August | Bereits in Gemini im Einsatz |
| Standard oder Opt-in | In der EU Standard, in der API aus | Standard | Standard |
| Öffentlicher Detektor? | Nein. Nur Forschende und Fachorganisationen | Als kommend angekündigt | Referenz-Detektor für Entwickler |
| Veröffentlichte Schwächen | Ja: Zahlen zu Bearbeitung und Länge | Anthropic warnt: Treffer ist kein Beleg für Urheberschaft | Google warnt: Umschreiben und Übersetzen senken die Sicherheit |
Das relativiert die Schlagzeile ein bisschen. Wer jetzt schreibt „OpenAI markiert alles", übertreibt. Claudes Markierung ist die umfassendere. OpenAIs ist die vorsichtigere, regionale, und es ist die einzige, bei der der Anbieter am Starttag Zahlen zur Robustheit veröffentlicht hat. Ein Kommentator auf X hat es so gesagt: Google und Anthropic hätten diese Regeln direkt global ausgerollt, die Kritik an OpenAIs EU-Variante sei insofern schwer nachzuvollziehen. Da ist schon was dran: Das Argument „Das ist nur EU-Bürokratie" erklärt nicht, warum zwei andere Anbieter es freiwillig weltweit tun.
Ist das ein Feigenblatt? Die deutsche Debatte einordnen
In den deutschsprachigen Reaktionen liefen zwei Linien nebeneinander. Die eine: „Die EU simuliert Transparenz", weil schon zehn Prozent Synonyme die Erkennung auf 66 Prozent drücken. Die andere: Es sei gut, wenn die EU ausländische Konzerne dazu bringe, nach europäischen Regeln zu spielen. Beide haben schon einen wahren Kern, und beide übersehen etwas.
Wo die Kritik recht hat. Die Zahlen sind ja nüchtern. Wer entschlossen ist, das Zeichen loszuwerden, schafft das mit Umschreiben, und OpenAI sagt das selbst. Auch Forschende warnen. Die Gruppe um Martin Vechev an der ETH Zürich hat in der Arbeit „Watermark Stealing" gezeigt: Aus Anfragen an ein markiertes Modell lassen sich dessen verborgene Regeln so weit rekonstruieren, dass man Zeichen entfernen oder fälschen kann. Der durchschnittliche Erfolg lag bei über 80 Prozent, die Kosten unter 50 Dollar, jeweils in den getesteten Aufbauten. Das Fälschen ist der heiklere Teil: Wenn jemand fremden Text so aussehen lassen kann, als wäre er markiert, ist ein Treffer kein sicherer Beleg mehr. Das wurde an anderen Verfahren getestet, nicht an textGrain, es zeigt aber, wohin die Diskussion führt.
Wo die Kritik zu kurz greift. Ein Wasserzeichen ist kein Fälschungsschutz und war nie als Lügendetektor gedacht. Für Regulierer geht es um etwas anderes: Plattformen und Forschende sollen große Mengen unbearbeiteten Maschinentexts erkennen können, also Spam, Bot-Netzwerke, Massenproduktion, bei der sich niemand die Mühe macht, umzuformulieren. Dafür reicht ja ein Signal, das bei unbearbeitetem Text zu 92 Prozent trägt.
Und der Datenschutz? In Deutschland kommt natürlich sofort die DSGVO-Frage. OpenAI sagt, das Wasserzeichen verknüpfe Text nicht mit Person, Organisation, Konto, Prompt oder Unterhaltung, und der Detektor melde nur, ob er ein OpenAI-Wasserzeichen findet, ohne Nutzer oder Eingaben offenzulegen. Das ist eine Herstellerangabe, die wir nicht unabhängig prüfen können. Sie passt aber schon zur Technik: Das Muster entsteht aus der Wortwahl und trägt keine eingebetteten Nutzerdaten. Wer personenbezogene Daten in ChatGPT eingibt, hat ein DSGVO-Thema, das mit dem Wasserzeichen nichts zu tun hat. Dazu mehr im Kurs KI und Datenschutz (DSGVO).
Wie viele betrifft das überhaupt? Laut einer repräsentativen Bitkom-Umfrage unter 1.005 Menschen ab 16 Jahren (März und April 2025) nutzen zwei Drittel (67 Prozent) in Deutschland zumindest gelegentlich generative KI. 43 Prozent nutzen ChatGPT, 39 Prozent Microsoft Copilot, 28 Prozent Google Gemini. Das sind Zahlen von vor anderthalb Jahren, heute dürfte der Anteil wohl höher liegen. Aber die Größenordnung zeigt ja: Es geht nicht um eine Nische.
Was das für dich bedeutet
Sieben Situationen, jeweils mit einer Empfehlung und einem ersten Schritt.
Wenn du studierst. Dein ChatGPT-Text kann in den kommenden Wochen ein Zeichen tragen, aber keine Hochschule kann es heute prüfen, und OpenAI sagt, ein Treffer belege nur, dass ein Modell Text verarbeitet hat. Das Risiko ist nicht das Wasserzeichen. Das Risiko ist, KI-Text als eigene Leistung einzureichen, obwohl deine Prüfungsordnung das verbietet. Erster Schritt: Lies noch diese Woche mal nach, was deine Hochschule zu KI-Nutzung und Eigenständigkeitserklärung sagt, und halte fest, wofür du KI nutzen darfst. Der Kurs KI für Studierende hilft dabei.
Wenn du unterrichtest. Du kannst den Detektor ja gar nicht nutzen, und ein Treffer würde einen Fall ohnehin nicht entscheiden. Robuster ist der Prozess: Aufgaben, die Denken über Zeit sichtbar machen, Entwürfe, Versionsgeschichte, ein Gespräch über den Text. Erster Schritt: Formulier mal eine klare KI-Regel für deinen Kurs. Der Kurs KI für Lehrkräfte zeigt, wie das geht.
Wenn du beruflich Texte schreibst (Texter:in, Agentur, Content-Team). Kund:innen werden fragen, ob dein Text KI-generiert ist. Ein Wasserzeichen kann „Wer hat gedacht?" eben nicht beantworten, und OpenAI sagt das selbst. Beim Veröffentlichen kann außerdem Artikel 50 Absatz 4 greifen. Erster Schritt: Leg jetzt fest, wie du den KI-Einsatz offenlegst (Vorlage unten), statt später defensiv zu antworten. Handwerkszeug dazu im Kurs Besser schreiben mit KI.
Wenn du dich bewirbst. Ein Anschreiben, das du mit ChatGPT entworfen hast, muss rechtlich nicht gekennzeichnet werden, kein Recruiter kann heute auf textGrain prüfen, und überarbeiteter Text verliert das Zeichen größtenteils sowieso. Was Bewerbungen wirklich schadet, sind generische, unbearbeitete KI-Texte. Erster Schritt: Schreib mindestens ein Viertel deines Entwurfs in eigenen Worten um, bring eine konkrete Geschichte unter, die nur du erzählen kannst, und behalt deinen eigenen Entwurf. Der Kurs Bewerbung mit KI zeigt einen schnelleren Ablauf.
Wenn du Entwickler:in bist oder eine App auf der OpenAI-API betreibst. Du hast eine Wahl, die ChatGPT-Nutzer:innen nicht haben. Die Option ist ja standardmäßig aus und lässt sich in den Projekt- oder Organisationseinstellungen für unterstützte Modelle aktivieren. Erster Schritt: Entscheide, ob deine Nutzer:innen Herkunftsnachweise brauchen (Compliance, Verlage, regulierte Branchen), und teste die Option erst mal in einem Staging-Projekt, bevor du Kunden etwas zusagst.
Wenn du im Mittelstand oder als Selbständige:r KI-Texte veröffentlichst. Hier ist die Kennzeichnungspflicht am ehesten relevant, vor allem, wenn du Texte zu Themen von öffentlichem Interesse veröffentlichst. Laut Computerwoche können auch Mitbewerber abmahnen. Erster Schritt: Schreib einen Satz zur redaktionellen Verantwortung in deinen Prozess (wer liest vor Veröffentlichung gegen?) und lies den Kurs EU AI Act: Was du wissen musst.
Wenn du in der Personalabteilung arbeitest. Lehne niemals Kandidat:innen allein wegen eines Wasserzeichen-Treffers ab. Er sagt ja nichts über den menschlichen Anteil aus. Für Einstellungsverfahren gelten außerdem eigene EU-Regeln, die wir in EU AI Act: Frist für Personalauswahl, was jetzt gilt erklärt haben. Erster Schritt: Schreib in deine Auswahlkriterien, dass KI-Spuren kein Ausschlussgrund sind, sondern höchstens ein Anlass für ein Gespräch.
Eine Vorlage: KI-Nutzungsnotiz
Die gesündeste Reaktion auf Wasserzeichen ist nicht, sie zu bekämpfen. Es ist, sauber zu dokumentieren, wie du KI genutzt hast, damit ein Detektor-Ergebnis, ob richtig oder falsch, nie dein einziger Beleg sein muss. Kopier dir das und pass es an.
KI-Nutzungsnotiz (zur Abgabedatei legen)

Dokument: [Titel]
Datum: [Datum]
Genutzte Tools: [ChatGPT / Claude / Gemini / keine]
Was die KI gemacht hat: [Gliederung | Grammatik | Abschnitte 2 und 4 entworfen | Übersetzung | nichts]
Was ich selbst gemacht habe: [Ideen, Struktur, Beispiele, Schlussredaktion, Faktencheck]
Wo die Entwürfe liegen: [Versionsverlauf in Google Docs / Word-Datei / Ordnerpfad]
Quellen, die ich selbst geprüft habe: [Liste]
Leg die Notiz in denselben Ordner wie deine Entwürfe. Wenn dich jemand fragt, zeigst du einen datierten Prozessnachweis, statt über eine Statistik zu streiten.
Sonderfälle und Fehlersuche
Das sind Fragen und Probleme, die in den ersten 24 Stunden aufgetaucht sind.
„Umgehe ich das mit einem VPN?" Siehe Schritt 5: Nicht gesichert, und halt auch kein guter Plan. OpenAI sagt außerdem, der regionale Ansatz sei vorläufig.
„Trägt Text das Zeichen, den ich selbst geschrieben und nur von ChatGPT glätten lassen habe?" Möglicherweise teilweise. Ein Modell, das deine Sätze neu formuliert, nutzt für diese Sätze ja seine eigenen Wortentscheidungen. OpenAI sagt aber ja selbst, ein Treffer verrate nichts über den menschlichen Anteil. Wenn dir die Unterscheidung wichtig ist, belegst du sie am besten mit der KI-Nutzungsnotiz.
„Entfernt Kopieren nach Word oder Google Docs das Zeichen?" Nein. Das Zeichen steckt in der Wortwahl, nicht in unsichtbaren Zeichen. Das Help Center nennt Kopieren und Einfügen unter den Veränderungen, die textGrain überstehen soll. Satz für Satz in eigenen Worten neu zu tippen schwächt es, weil du die Entscheidungen ersetzt.
„Was ist mit Übersetzungen?" OpenAI sagt, übersetzter Text sei schwerer zu erkennen. Eine Zahl gibt es nicht. Betrachte „übersetzt, also unmarkiert" als wahrscheinlich, aber unbewiesen, und weise auf Übersetzungshilfe hin, wo deine Regeln es verlangen.
„Wird auch Code markiert?" OpenAI sagt, Codex-Text sei erfasst. Code hat aber eben wenig Wortspielraum, und OpenAIs eigene Grafik zeigt, dass bei Inhalten mit wenig Flexibilität (etwa Mathematik) die Erkennung deutlich schwächer ist. In Kommentaren und Dokumentation dürfte das Signal stärker sein als im Code selbst.
„Eine Seite sagt, sie könne meinen Text auf das ChatGPT-Wasserzeichen prüfen." Sie nutzt nicht OpenAIs Detektor. Gib dort nichts Vertrauliches ein.
„Ein ‘Humanizer’ oder ‘Remover’ verspricht, das Wasserzeichen zu entfernen." Manche mindern es vielleicht, weil starkes Umschreiben es schwächt. Du kannst das Ergebnis aber nun mal nicht prüfen, und das Umschreiben kann deinen Text verschlechtern oder Fehler einbauen. Wenn dein Ziel Text ist, der nach dir klingt, ist Selbst-Überarbeiten billiger und sicherer.
„Ein Detektor hat meinen selbst geschriebenen Text markiert." Ruhe bewahren und nach Einzelheiten fragen: welcher Detektor, welcher Schwellenwert, welche Länge, welche weiteren Belege außer dem Score. Ein Wasserzeichen-Ergebnis ist ein Hinweis, kein Urteil. Bring deine Entwürfe und den Versionsverlauf mit.
Was textGrain nicht kann
- Es beweist nicht, dass ein Mensch geschrieben hat. OpenAI schreibt ausdrücklich: Das Fehlen eines erkannten Wasserzeichens beweise keine menschliche Urheberschaft. Der Text kann zu kurz, überarbeitet, übersetzt, von einem anderen Anbieter oder von vor dem Rollout sein.
- Es sagt nicht, wer gedacht hat. Ein Wasserzeichen misst den menschlichen Anteil ja nicht. Wer alle Ideen selbst hatte und nur Grammatik prüfen ließ, sieht für einen Detektor ähnlich aus wie jemand, der einen Prompt eingefügt hat.
- Es identifiziert dich nicht. OpenAI sagt, es verknüpfe Text nicht mit Person, Konto, Prompt oder Unterhaltung.
- Es übersteht entschlossenes Bearbeiten nicht. Bei einem Viertel ersetzter Wörter sinkt OpenAIs eigene Erkennung auf 17 Prozent.
- Es taugt nicht als Beweis in einem Streit. Falsch-Positive gibt es (etwa ein Prozent bei der getesteten Einstellung), Fälschungsangriffe sind bei anderen Verfahren gezeigt worden, und der Detektor ist noch nicht unabhängig geprüft.
Was es kann: Plattformen und Forschenden helfen, große Mengen unbearbeiteten Maschinentexts zu erkennen, also Spam, Bot-Netzwerke und Massenproduktion. Das ist schon näher an dem, was Regulierer erreichen wollen, als das Erwischen einer einzelnen Hausarbeit.
FAQ
Markiert ChatGPT jetzt alle meine Texte? Nein. OpenAI sagt, es werde in der EU in den kommenden Wochen einen unsichtbaren Wasserzeichen-Standard für infrage kommende ChatGPT- und Codex-Texte einführen. Es ist kein globaler Standard. API-Kunden weltweit können es für ausgewählte Modelle aktivieren, standardmäßig aus.
Was ist textGrain? OpenAIs Text-Wasserzeichen-Verfahren. Es lenkt die zufälligen Entscheidungen des Modells zwischen ähnlichen Wörtern so, dass ein Detektor mit geheimem Schlüssel später ein statistisches Muster finden kann. Es fügt keine sichtbaren Marken und keine versteckten Zeichen ein.
Kann jemand prüfen, ob mein Text das Wasserzeichen hat? Heute nicht. OpenAI gibt den Detektor zum Start nur an genehmigte Forschende und Fachorganisationen. Webseiten, die textGrain-Prüfungen anbieten, nutzen nicht OpenAIs Detektor.
Erfährt OpenAI oder jemand anderes dadurch, wer ich bin oder was ich eingegeben habe? Laut OpenAI nein. Das Wasserzeichen verknüpft Text ja nicht mit Person, Organisation, Konto, Prompt oder Unterhaltung, und der Detektor meldet nur, ob er ein OpenAI-Wasserzeichen findet.
Kann ich es ausschalten? OpenAIs Ankündigung beschreibt für ChatGPT in der EU keine Nutzereinstellung. Das Unternehmen sagt, es wolle „wenn möglich" Wahlfreiheit geben. API-Kunden können es in den Projekt- oder Organisationseinstellungen einschalten. Ob es sich tatsächlich „nicht abschalten" lässt, beantworten OpenAIs Seiten weder mit Ja noch mit Nein.
Entfernt Bearbeiten das Wasserzeichen? Es schwächt es. In OpenAIs Test mit 400-Token-Texten sank die Erkennung von etwa 92 auf etwa 66 Prozent, wenn 10 Prozent der Wörter ersetzt wurden, und auf etwa 17 Prozent bei 25 Prozent. Starkes Umschreiben oder Übersetzen kann es unauffindbar machen.
Können meine Lehrkraft oder mein Arbeitgeber mich damit erwischen? Nicht mit OpenAIs Detektor, auf den sie keinen Zugriff haben. Und selbst wenn: OpenAI sagt, ein Ergebnis zeige weder, wie viel vom Text menschlich war, noch wem er gehört, noch ob eine Regel verletzt wurde.
Ist Claudes Wasserzeichen anders? Ja. Anthropic sagt, sein Wasserzeichen (eine Variante von Googles SynthID-Text) gelte weltweit auf unterstützten neuen Claude-Modellen, nicht nur in der EU. OpenAIs ist regional, und der Detektor ist eingeschränkt. Mehr dazu in unserem Beitrag zum Claude-Wasserzeichen.
Warum zuerst die EU? Weil Artikel 50 Absatz 2 des EU AI Act seit dem 2. August 2026 von Anbietern verlangt, synthetischen Text maschinenlesbar zu kennzeichnen. Eine Übergangsfrist bis zum 2. Dezember 2026 für Systeme, die schon am Markt waren, erklärt den schrittweisen Rollout.
Sollte ich ChatGPT jetzt nicht mehr zum Schreiben nutzen? Nein. Das praktische Risiko ist eben nicht das Wasserzeichen, sondern KI-Hilfe als eigene Arbeit auszugeben, wo deine Regeln das verbieten. Nutze KI, überarbeite den Text so, dass er wirklich deiner ist, behalte deine Entwürfe und halte dich an die Regeln deiner Hochschule oder deines Arbeitgebers.
Das Fazit
textGrain ist schon eine echte Änderung, aber kleiner und vorsichtiger, als die Schlagzeilen vermuten lassen. ChatGPT- und Codex-Texte in der EU bekommen in den kommenden Wochen ein unsichtbares, statistisches Zeichen. Außerhalb der EU gehörst du nicht zum Standard-Rollout. Außer einer kleinen Gruppe genehmigter Forschender kann es niemand prüfen. Und OpenAIs eigene Zahlen zeigen, wie schnell es verblasst: Bei einem Viertel ersetzter Wörter bleibt eine Erkennung von etwa 17 Prozent.
Also weder Panik noch Tricksen. Versteh, was das Ding kann, halt dich an die Regeln, an die du tatsächlich gebunden bist, und dokumentiere, wie du KI genutzt hast. Eine kurze KI-Nutzungsnotiz und ein Ordner mit datierten Entwürfen sind mehr wert als jedes Wasserzeichen-Ergebnis, für dich wie gegen dich.
Wenn du KI sicher und ohne Bauchschmerzen im Job und im Studium einsetzen willst: Der Kurs EU AI Act: Was du wissen musst erklärt die Regeln ohne Juristendeutsch. KI-Grundlagen zeigt, was diese Werkzeuge können und was nicht. Und KI und Datenschutz (DSGVO) hilft dir bei den Datenschutzfragen, die mit dem Wasserzeichen nichts zu tun haben, aber mindestens genauso wichtig sind. Wer wissen will, was ein Wasserzeichen im Vergleich zu einem KI-Detektor ist, findet das in unserem Glossar-Eintrag What Is an AI Text Watermark? (auf Englisch).
Quellen
- OpenAI, „Our approach to EU text provenance rules" (5. Oktober 2026)
- OpenAI Help Center, „Provenance signals in OpenAI-generated content"
- OpenAI, textGrain-Technikbericht „Entropy-calibrated watermarking for language model text"
- the-decoder.de, „OpenAI versieht ChatGPT-Texte mit unsichtbarem Wasserzeichen"
- Schmidtis Blog, „OpenAI textGrain: EU-Wasserzeichen scheitert an Synonymen"
- WinFuture, „OpenAI plant unsichtbares Wasserzeichen für ChatGPT in der EU"
- all-ai.de, „ChatGPT erhält in der EU ein unsichtbares Text-Wasserzeichen"
- Stadt Bremerhaven, „OpenAI: Text-Wasserzeichen für EU-Nutzer"
- Computerwoche, „KI-Kennzeichnungspflicht: Das gilt jetzt"
- TechCrunch, „OpenAI will start watermarking ChatGPT’s text in the EU" (5. Oktober 2026)
- Bitkom-Umfrage zur Nutzung generativer KI, Einordnung bei ChannelPartner
- ifun.de, „ChatGPT und Claude: KI-Texte bekommen unsichtbare Wasserzeichen" (12. August 2026)
- EU AI Act, Artikel 50: Transparenzpflichten
- Europarat/MERLIN, Kodex für die Transparenz KI-generierter Inhalte
- Cloud Security Alliance, Hinweis zur Artikel-50-Frist im Dezember 2026
- Jovanović, Staab und Vechev (ETH Zürich), „Watermark Stealing in Large Language Models"
- Google DeepMind, SynthID-Text (Nature)