Lunedì sera, sotto l’annuncio di OpenAI, qualcuno ha scritto su X una domanda che riassume bene il disorientamento di molti: se copio un testo da ChatGPT e lo modifico in un altro programma, come fa a tenersi il watermark? E se uso un’altra IA, il problema non sparisce comunque? Un altro utente, più sbrigativo, ha commentato che il watermark resta «un indizio, non una prova». Entrambi hanno ragione, e su tutti e due i punti OpenAI è sorprendentemente d’accordo.
Il sistema si chiama textGrain. Nelle prossime settimane ChatGPT e Codex inizieranno a inserire un watermark invisibile nei testi generati per gli utenti nell’Unione europea, Italia compresa. Non è un’etichetta visibile e non aggiunge caratteri nascosti. E controllare un testo, per ora, non si può: il rilevatore non è pubblico.
In questo articolo vediamo cosa ha annunciato OpenAI, cosa significa per chi usa ChatGPT in Italia, quanto è fragile il watermark (i numeri li ha pubblicati OpenAI stessa) e cosa conviene fare, che tu sia studente, docente, copywriter, freelance o semplicemente una persona che usa ChatGPT per le mail di lavoro. Ho letto l’annuncio di OpenAI e il suo articolo del Help Center, la copertura di TechCrunch e dei siti italiani che l’hanno ripresa (Blog.it e altri), l’analisi legale di Cybersecurity360 sull’articolo 50 dell’AI Act, i dati Istat sull’uso dell’IA generativa e le reazioni in italiano su X. Quello che è confermato lo dico. Quello che OpenAI non ha detto (e non è poco) lo dico lo stesso, perché una buona parte di quello che circola è supposizione presentata come fatto.
Cos’è textGrain, in parole semplici
Un watermark in un testo fa pensare a qualcosa che si possa vedere o selezionare. textGrain non è così. OpenAI lo descrive nel suo Help Center come «un cambiamento invisibile nella casualità con cui il modello sceglie le parole».
Diciamo così: quando ChatGPT scrive una frase, sceglie di continuo tra parole che andrebbero bene tutte. «Iniziare» o «cominciare», «grande» o «enorme», «ma» o «però». Quasi sempre è una scelta a testa o croce. textGrain pilota quelle scelte con una chiave segreta. Su qualche centinaio di parole nasce così uno schema statistico, che un rilevatore in possesso della chiave può andare a cercare. Tu che leggi vedi un testo normalissimo.
Da qui discendono tre conseguenze, e spiegano quasi tutto il resto:
- Il segnale sta nella scelta delle parole, non in caratteri nascosti. Secondo il Help Center, textGrain non aggiunge caratteri invisibili, spazi nascosti o punteggiatura strana. Quindi copiare e incollare in Word o in Google Docs non lo toglie, e uno strumento per «rimuovere i caratteri invisibili» non serve a niente. (Nel 2025 giravano storie su caratteri speciali dentro i testi di ChatGPT: era un trucco molto più semplice, e con textGrain non c’entra.)
- Serve lunghezza. Una frase da sola ha troppe poche scelte di parole per formare uno schema. Qualche centinaio di parole bastano.
- Cambiare le parole significa cambiare la prova. Se riscrivi il testo, sostituisci proprio le scelte di cui lo schema è fatto.
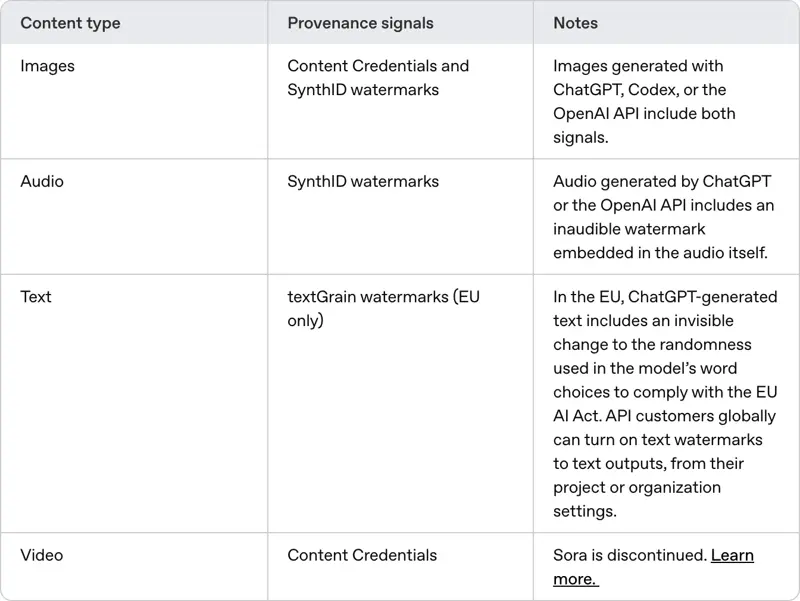
Per immagini e audio OpenAI usa già watermark (SynthID, di Google DeepMind) e Content Credentials. Il testo, insomma, è la novità, ed è il primo caso in cui il rilevatore, di proposito, non è pubblico.
Cosa ha annunciato OpenAI il 5 ottobre (i fatti confermati)
Tutto quello che c’è in questa tabella viene dall’annuncio di OpenAI e dal suo articolo del Help Center. TechCrunch e Blog.it riportano gli stessi numeri.
| Domanda | Cosa dice OpenAI |
|---|---|
| Chi riceve testo con watermark di default? | Il testo «eligible» di ChatGPT e Codex «nell’Unione europea», su tutti i piani |
| Quando? | «Over the coming weeks», cioè nelle prossime settimane. Nessuna data precisa: il tuo account potrebbe non essere ancora coinvolto |
| È globale? | No. OpenAI non rende il watermark di testo «un’impostazione globale predefinita al lancio» |
| E l’API? | Gli sviluppatori di tutto il mondo possono attivarlo dal 5 ottobre su «modelli selezionati». Disattivato di default |
| Dove si attiva nell’API? | Nelle impostazioni del progetto o dell’organizzazione (secondo il Help Center) |
| Posso far verificare un testo? | Non pubblicamente. Rilevatore riservato a «ricercatori e organizzazioni esperte» approvati |
| Mi identifica? | No. Secondo OpenAI, non collega il testo a una persona, un account, un prompt o una conversazione |
| Peggiora la qualità? | OpenAI non vede differenze significative nei suoi benchmark |
| Sarà open source? | OpenAI dice di voler rilasciare la tecnologia in open source, senza data |
| Perché adesso? | Gli obblighi di trasparenza dell’AI Act, applicabili dal 2 agosto 2026 |
Qualche punto su cui mi fermo un momentino.
In UE sì, altrove no. OpenAI dice di non voler fare del watermark di testo «un’impostazione globale predefinita al lancio» e che l’approccio regionale le dà «margine per imparare dall’uso reale». Se usi ChatGPT dagli Stati Uniti, l’annuncio non ti mette nel rollout predefinito. L’eccezione: il testo che esce da un’app costruita sull’API di OpenAI il cui sviluppatore abbia attivato l’opzione.
Il rilevatore non è un prodotto. OpenAI accetta le candidature di ricercatori e organizzazioni in grado di aiutarla a valutarlo. Il Help Center cita tra i partner John Thickstun (Cornell), Martin Vechev (ETH Zurigo e INSAIT) e il Kempelen Institute. Un insegnante, una redazione, un ufficio HR o tu stesso, oggi, non potete verificare proprio niente. Comunque, qualunque cosa ti propongano online come «verificatore del watermark di ChatGPT» non usa il rilevatore di OpenAI.
OpenAI ha pubblicato i propri punti deboli. Beh, è insolito, e merita un riconoscimento. Vuol dire anche che non dobbiamo indovinare quanto sia fragile.
Quanto funziona? I numeri di OpenAI
OpenAI ha testato textGrain con un tasso obiettivo di falsi positivi dell'1%. In pratica, il rilevatore è tarato per segnare per errore un testo senza watermark circa una volta su cento. Con questa impostazione:
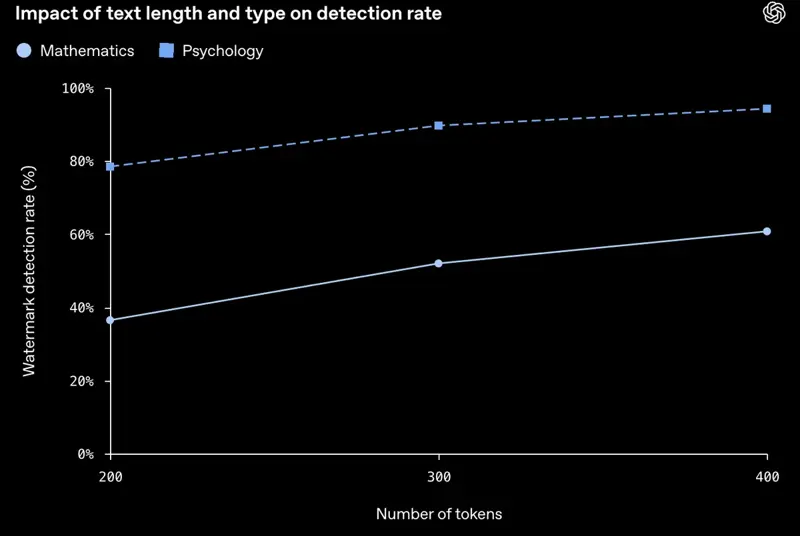
- Circa il 95% dei brani da 400 token (all’incirca 300 parole) viene rilevato, per testi di tipo psicologia.
- Circa l’80% con 200 token (circa 150 parole).
- Per la matematica, dove c’è pochissimo margine nella scelta delle parole, la rilevazione è «sensibilmente più bassa». Sul grafico pubblicato leggo grosso modo il 37% a 200 token e il 61% a 400.
E adesso la parte che conta per chiunque ritocchi i propri testi (cioè quasi tutti). Su brani da 400 token:
- Non modificato: circa il 92% rilevato.
- 10% delle parole sostituito con sinonimi: la rilevazione scende a circa il 66%.
- 25% delle parole sostituito: scende a circa il 17%.
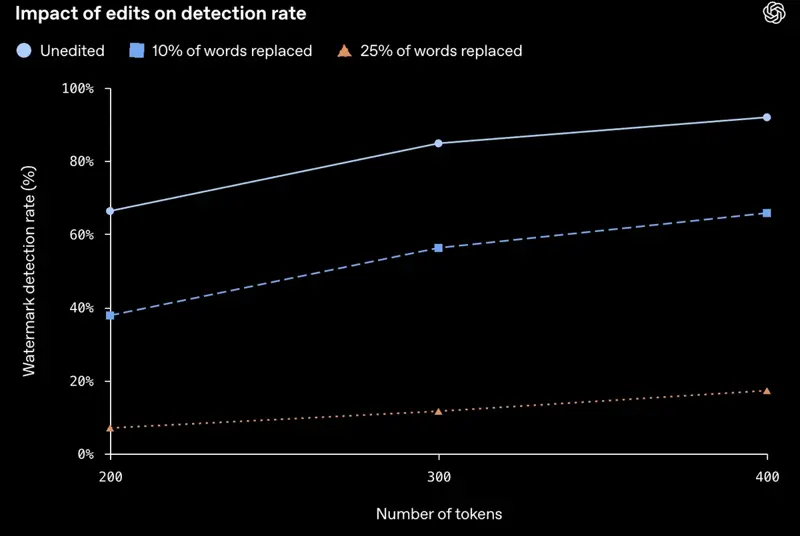
Secondo OpenAI, anche i testi tradotti sono più difficili da rilevare, e una riscrittura profonda può rendere il watermark introvabile. Per le traduzioni OpenAI non dà nessun numero. (Per noi non è un dettaglio: quanti, in Italia, usano ChatGPT per tradurre dall’inglese o per riformulare un testo già tradotto?)
Sulla qualità: OpenAI ha confrontato il suo modello più recente (Astra) con e senza watermark su vari benchmark. L’indice di intelligenza di Artificial Analysis dà 49,57 punti senza e 49,76 con. GPQA Diamond: 94,44% contro 93,94%. BrowseComp: 87,92% contro 87,35%. Le differenze vanno in entrambe le direzioni, ed è così che si presenta in pratica «nessuna differenza significativa». Non ti dice come verrà la tua mail del lunedì mattina, ma almeno c’è un numero dove prima c’erano solo promesse.
Un’affermazione che leggerai di sicuro: nei test di OpenAI, textGrain ha eguagliato o superato altri metodi, SynthID per il testo compreso. È la valutazione di OpenAI stessa. A un giorno dall’annuncio non esisteva nessun test indipendente.
L’esempio pratico: una lettera da 300 parole, quattro scenari
Le percentuali sono scivolose, quindi prendiamo un documento concreto: una lettera di presentazione di 300 parole. Come regola pratica, un token vale circa tre quarti di parola, quindi sono più o meno 400 token, esattamente la dimensione testata da OpenAI.
Scenario A: incolli la bozza di ChatGPT così com’è. Nel test di OpenAI, un rilevatore riconoscerebbe circa 92 brani su 100 di questo tipo. Se qualcuno avesse un rilevatore (e quasi nessuno ce l’ha), la probabilità di riconoscerlo sarebbe alta.
Scenario B: cambi una parola su dieci. In 300 parole sono circa 30. La rilevazione scende a circa 66 su 100. Hai lavorato bene sul testo, ma il segnale c’è ancora, più probabilmente che no.
Scenario C: riscrivi una parola su quattro. Circa 75 parole. La rilevazione scende a circa 17 su 100. Chi vuole che il testo «suoni come me» di solito cambia almeno altrettanto.
Scenario D: scrivi la lettera da solo e chiedi a ChatGPT solo di correggere tre virgole. Qui i numeri che ho citato non valgono nemmeno. Il modello ti ha restituito il tuo testo con modifiche minime, quindi quasi niente viene dalle sue scelte casuali. Lo stesso Help Center di OpenAI precisa che un watermark non indica in che misura abbia contribuito un modello. Può suggerire che un modello abbia elaborato del testo. Non mostra chi ha pensato.
Comunque, c’è anche il rovescio della medaglia. Il rilevatore è tarato per sbagliare su un testo senza watermark circa una volta su cento. Se un’università passasse 300 elaborati scritti a mano in un rilevatore del genere, dovrebbe aspettarsi circa tre falsi allarmi (l'1% di 300). Tre studenti sospettati di qualcosa che non hanno fatto. È uno dei motivi per cui OpenAI non rende pubblico il rilevatore «visti i rischi di watermark non rilevati e di falsi positivi», ed è il motivo per cui un risultato positivo non dovrebbe mai valere come prova.
Quanti, in Italia, sono davvero coinvolti? Il dato Istat
Qui l’Italia ha una particolarità che il resto d’Europa non ha. Secondo l’indagine Istat «Aspetti della vita quotidiana» del 2025, che per la prima volta ha misurato l’uso dell’intelligenza artificiale generativa, solo il 19,9% degli italiani tra i 16 e i 74 anni ha usato strumenti come chatbot, generatori di immagini o di codice negli ultimi tre mesi. Un risultato che ci mette penultimi in Europa, davanti alla sola Romania (17,8%) e molto sotto la media UE27, che arriva al 32,7%.
Il divario più grande lo fa il titolo di studio: tra chi ha 25 anni o più, usa questi strumenti il 32% dei laureati e appena il 3,6% di chi ha al massimo la licenza media. C’è anche una differenza territoriale: 19,7% al Nord, 18,8% al Centro, 14,6% nel Mezzogiorno. Tra i ragazzi di 14-19 anni l’uso dichiarato è del 51,2%, tra i 20-24enni del 43,1%. E quasi il 60% di chi non la usa dice semplicemente di non averne bisogno.
Cosa vuol dire per textGrain? Che il watermark riguarderà, nei fatti, una minoranza di italiani, ma quella minoranza coincide con chi scrive, studia e lavora molto con i testi: professionisti, studenti, laureati. Cioè le persone per cui «chi ha scritto cosa» ha conseguenze concrete.
Mi riguarda? Il controllo in sei passaggi
Non esiste un verificatore. «Il mio testo ha il watermark?» in realtà significa «potrebbe averlo?». Ecco come capirlo.
Passaggio 1: dove è stato generato il testo?
- Con ChatGPT o Codex, da un account che usi nell’UE: è il gruppo che, secondo OpenAI, riceverà il watermark «nelle prossime settimane».
- Con ChatGPT da fuori dell’UE: OpenAI non ha annunciato alcun rollout predefinito.
- Con un’app o un sito costruito sull’API di OpenAI: ha il watermark solo se lo sviluppatore l’ha attivato, e solo su «modelli selezionati».
- Con Claude, Gemini o un altro strumento: regole diverse. Anthropic applica il watermark a Claude in tutto il mondo sui modelli recenti compatibili, e il SynthID di Google è già dentro Gemini.
Passaggio 2: la data. OpenAI dice «nelle prossime settimane», non «oggi». Un testo scritto prima che il rollout arrivi sul tuo account non ha il watermark, e OpenAI precisa che il testo anteriore al watermark non è rilevabile.
Passaggio 3: la lunghezza. Sotto le 100-150 parole spesso il segnale è troppo scarso. Oltre le 300 parole di output del modello non modificato, ce n’è in abbondanza.
Passaggio 4: quanto hai cambiato? Se più di un quarto delle parole è tuo, secondo OpenAI un rilevatore scatterebbe solo in circa un caso su sei. Se hai toccato solo la punteggiatura, è praticamente tutto invariato.
Passaggio 5: la questione VPN. Su X in italiano praticamente nessuno l’ha posta, ma in altre lingue sì: c’è chi suggerisce di passare da un proxy per evitare il watermark. Nulla lo conferma. OpenAI non ha detto come decide chi conta come utente UE (IP, account, paese di fatturazione?). Le uniche risposte che circolano sono supposizioni, comprese quelle di un chatbot. Non costruirci sopra niente. E anche se funzionasse, OpenAI dice che rivedrà «ogni parte di questo approccio», e la tua scuola o il tuo datore di lavoro non ti chiederanno comunque l’indirizzo IP.
Passaggio 6: dimentica i siti «verificatori». Un sito che promette di controllare il tuo testo contro il «watermark di ChatGPT» non può usare il rilevatore di OpenAI. O è un classificatore che tira a indovinare, o è una pagina che vuole i tuoi dati. Non incollarci niente di riservato.
Perché l’UE, e cosa chiede davvero la legge
Il motivo è un solo articolo dell’AI Act. L’articolo 50, paragrafo 2, obbliga i fornitori di sistemi di IA generativa a marcare i risultati sintetici (testo, immagini, audio, video) in un formato leggibile dalle macchine. Si applica dal 2 agosto 2026. C’è un’eccezione per i sistemi che si limitano a un’«assistenza standard alla modifica» o che non alterano in modo sostanziale quello che ricevono. Per questo un testo scritto da te e fatto solo ripulire resta in una zona grigia.
Per l’Italia, la legge n. 132/2025 indica nell’articolo 20 l’Agenzia per l’Italia digitale (AgID) e l’Agenzia per la cybersicurezza nazionale (ACN) come le due autorità nazionali competenti in materia di intelligenza artificiale, ciascuna per il proprio ambito. Le sanzioni dell’AI Act per le violazioni degli obblighi di trasparenza possono arrivare a 15 milioni di euro o al 3% del fatturato mondiale. Attenzione: riguardano i fornitori e le aziende che pubblicano contenuti generati dall’IA, non te quando usi ChatGPT per conto tuo.
Due date da ricordare:
- 2 agosto 2026: l’articolo 50 si applica. I sistemi nuovi dovrebbero partire già con la marcatura incorporata. Per questo Anthropic ha attivato quel giorno il watermark di Claude.
- 2 dicembre 2026: fine di una transizione di quattro mesi che il pacchetto «Digital Omnibus» ha concesso, solo per l’obbligo di marcatura leggibile dalle macchine, ai sistemi già sul mercato prima del 2 agosto. Spiega perché OpenAI distribuisce textGrain «nelle prossime settimane» e non dall’oggi al domani.
Intorno alla legge c’è un codice di buone pratiche sulla trasparenza dei contenuti generati dall’IA, volontario, pubblicato dalla Commissione europea il 10 giugno 2026. La prima lista di firmatari, del 31 luglio, contava circa 190 organizzazioni, tra cui OpenAI, Anthropic, Google, Microsoft, Meta e Mistral. OpenAI scrive nel suo Help Center che il watermark di testo è in linea con gli impegni presi in quel codice.
Un’analisi su Cybersecurity360 dell’avvocato Andrea Michinelli, datata 1 giugno 2026, aiuta a inquadrare la questione. Cita tre studi tecnici della Commissione europea di maggio 2026 e ne ricava due cose: nessuna singola tecnica soddisfa insieme i quattro requisiti di efficacia, interoperabilità, robustezza e affidabilità, e il watermarking sul testo è poco efficace sotto i 30-50 token. Da qui la sua lettura: un obbligo di mezzi, cioè adottare la migliore combinazione disponibile, aggiornarla e documentare i limiti residui. È più o meno quello che sta facendo OpenAI, con la differenza che i limiti li documenta in pubblico.
Due cose che la legge non fa. Non impone una scritta visibile «scritto da un’IA» su ogni documento assistito dall’IA. E non trasforma un watermark rilevato in prova legale di un imbroglio. Per i testi pubblicati di interesse pubblico può scattare un obbligo di informare, a meno che una persona li abbia rivisti e qualcuno si assuma la responsabilità editoriale.
textGrain, Claude e Gemini a confronto
I tre grandi assistenti usano ormai una variante della stessa idea. Cambiano gli ambiti: chi è coinvolto e chi può verificare.
| OpenAI (ChatGPT, Codex) | Anthropic (Claude) | Google (Gemini) | |
|---|---|---|---|
| Tecnica | textGrain (segnale statistico nella scelta delle parole) | Variante del SynthID-Text di Google, secondo Anthropic | SynthID-Text |
| Dove si applica | ChatGPT e Codex in UE, «nelle prossime settimane»; API facoltativa nel mondo | Modelli recenti compatibili, in tutto il mondo, dal 2 agosto | Già in uso in Gemini |
| Predefinito o facoltativo | Predefinito in UE, disattivato di default nell’API | Predefinito | Predefinito |
| Rilevatore pubblico? | No. Ricercatori e organizzazioni esperte | Annunciato come in arrivo | Rilevatore di riferimento per gli sviluppatori |
| Punti deboli pubblicati | Sì: numeri su modifiche e lunghezza | Anthropic avverte che un positivo non prova la paternità | Google avverte che riscrivere o tradurre riduce l’affidabilità |
Dire «OpenAI marchia tutto» è quindi un’esagerazione. Quello di Claude è il più esteso. Quello di OpenAI è il più prudente e il più regionale, ed è l’unico di cui il fornitore ha pubblicato, il primo giorno, i dati di robustezza.
Un indizio, non una prova: la mia lettura
Il commento in italiano più lucido che ho trovato è una frase sola: per chi lo ha scritto, il watermark resta «un indizio, non una prova». Sono d’accordo, e vale la pena capire in che senso.
Dove le critiche hanno ragione. I numeri sono sobri. Chi vuole liberarsi del watermark ci riesce riscrivendo, e OpenAI lo dice. Anche i ricercatori avvertono: il gruppo di Martin Vechev all’ETH di Zurigo ha mostrato in «Watermark Stealing» che basta interrogare un modello con watermark per ricostruire abbastanza delle sue regole nascoste da cancellare o falsificare il marchio. Il tasso di successo medio supera l'80% e i costi restano sotto i 50 dollari nelle configurazioni testate. Il guaio più serio è la falsificazione: se qualcuno può far sembrare marcato un testo estraneo, un risultato positivo non è più una prova sicura. È stato dimostrato su altri metodi, non su textGrain, ma fa capire dove va la discussione.
Dove le critiche si fermano. Un watermark non è un antifrode e non è mai stato pensato come macchina della verità. Per chi regola l’obiettivo è un altro: permettere a piattaforme e ricercatori di individuare grandi volumi di testo di macchina non modificato, come spam e reti di bot, insomma produzione di massa dove nessuno si prende la briga di riformulare. Per questo basta un segnale che regge al 92% sul testo grezzo.
E la privacy? Secondo OpenAI, il watermark non collega il testo a una persona, a un’organizzazione, a un account, a un prompt o a una conversazione, e il rilevatore segnala soltanto se trova un watermark di OpenAI, senza rivelare l’utente né ciò che ha scritto. È una dichiarazione del fornitore che non possiamo verificare in modo indipendente, ma è coerente con la tecnica: lo schema nasce dalla scelta delle parole e non contiene dati dell’utente incorporati. Se incolli dati personali in ChatGPT hai una questione di protezione dei dati che col watermark non c’entra. Resta, insomma, un discorso a parte.
Cosa significa per te
Sette situazioni, ciascuna con una raccomandazione e una prima mossa.
Se studi. Il tuo testo di ChatGPT può avere un watermark nelle prossime settimane, ma nessuna università può verificarlo oggi, e OpenAI dice che un positivo mostra solo che un modello ha elaborato il testo. Il rischio non è il watermark. Il rischio è consegnare come tuo un testo dell’IA dove il regolamento lo vieta. Prima mossa: questa settimana rileggi le regole sull’IA del tuo ateneo e annota per cosa puoi usarla.
Se insegni. Quel rilevatore non lo puoi usare, e un risultato positivo, comunque, non risolverebbe un caso. Più solido è il processo: compiti che mostrano il pensiero nel tempo, bozze, cronologia delle versioni, un colloquio sul testo. Prima mossa: scrivi una regola chiara sull’IA per il tuo corso. Il corso L’IA per gli insegnanti ti mostra come.
Se scrivi per mestiere (copywriter, agenzia, team contenuti). I clienti ti chiederanno se il testo l’ha generato l’IA. Un watermark non risponde a «chi ha pensato?», e lo dice OpenAI stessa. In fase di pubblicazione, in più, può entrare in gioco l’articolo 50, paragrafo 4. Prima mossa: stabilisci subito come dichiarare l’uso dell’IA (qui sotto c’è un modello), invece di giustificarti dopo. Un buon punto di partenza è il corso Prompt efficaci per ChatGPT.
Se cerchi lavoro. Una lettera di presentazione abbozzata con ChatGPT non ha obblighi di dichiarazione, nessun recruiter può controllare textGrain oggi, e un testo che hai rielaborato perde comunque gran parte del segnale. Quello che danneggia davvero le candidature è il testo generico dell’IA, non ritoccato. Prima mossa: riscrivi con parole tue almeno un quarto della bozza, aggiungi un episodio concreto che solo tu puoi raccontare e tieni la tua versione.
Se sei sviluppatore o gestisci un’app sull’API di OpenAI. Hai una scelta che chi usa ChatGPT non ha. L’opzione è disattivata di default e si attiva nelle impostazioni del progetto o dell’organizzazione per i modelli compatibili. Prima mossa: decidi se i tuoi utenti hanno bisogno di una prova di provenienza (conformità, editori, settori regolati) e prova l’opzione su un progetto di staging prima di promettere qualcosa ai clienti.
Se hai una PMI o pubblichi contenuti generati dall’IA. È il caso in cui l’obbligo di informare ha più probabilità di scattare, soprattutto per testi di interesse pubblico. Prima mossa: scrivi una frase di responsabilità editoriale nel tuo processo (chi rilegge prima di pubblicare?) e guarda il corso Alfabetizzazione IA (art. 4 AI Act). Per la parte sull’etichettatura nel commercio online ti serve anche Etichettatura IA dal 2 agosto: cosa serve davvero al tuo negozio online.
Se lavori nelle risorse umane. Non scartare mai un candidato per un solo risultato positivo del watermark: non dice nulla sulla parte umana del testo. Prima mossa: scrivi nei criteri di selezione che le tracce di IA non sono un motivo di esclusione, al massimo uno spunto per un colloquio.
Un modello: la nota sull’uso dell’IA
La reazione più sana ai watermark non è combatterli. È tenere una traccia pulita di come hai usato l’IA, così che il risultato di un rilevatore, giusto o sbagliato, non sia mai la tua unica prova. Copia questo e adattalo.
Nota sull'uso dell'IA (da tenere con il file finale)

Documento: [titolo]
Data: [data]
Strumenti usati: [ChatGPT / Claude / Gemini / nessuno]
Cosa ha fatto l'IA: [scaletta | correzioni grammaticali | bozza delle sezioni 2 e 4 | traduzione | niente]
Cosa ho fatto io: [idee, struttura, esempi, revisione finale, verifica dei dati]
Dove sono le bozze: [cronologia versioni di Google Docs / file Word / cartella]
Fonti che ho controllato io: [elenco]
Mettila nella stessa cartella delle tue bozze. Se qualcuno te lo chiede, mostri una traccia datata invece di discutere di una statistica.
Casi particolari e risoluzione dei problemi
Sono le domande e i problemi comparsi nelle prime 24 ore.
«Funziona con una VPN?» Vedi il passaggio 5: non è confermato, e non è un buon piano. OpenAI dice inoltre che l’approccio regionale è provvisorio.
«Un testo che ho scritto io e fatto solo rifinire a ChatGPT ha il watermark?» Mah, forse in parte. Un modello che riformula le tue frasi usa per quelle frasi le sue scelte di parole. Ma OpenAI dice che un positivo non rivela quanto abbia contribuito una persona. Se per te la distinzione conta, la nota sull’uso dell’IA è il modo per dimostrarla.
«Se lo copio in Word o Google Docs, il watermark sparisce?» No. Il segnale sta nella scelta delle parole, non in caratteri invisibili. Il Help Center mette il copia e incolla tra le modifiche che textGrain deve reggere. Riscrivere frase per frase con parole tue lo indebolisce, perché sostituisci le scelte.
«E se traduco il testo?» OpenAI dice che il testo tradotto è più difficile da rilevare. Un numero non c’è. Considera «tradotto, quindi senza watermark» come probabile ma non dimostrato, e dichiara l’aiuto di traduzione dove le tue regole lo richiedono.
«Anche il codice di Codex viene marcato?» OpenAI dice che il testo di Codex rientra. Ma il codice lascia poco margine nelle parole, e il grafico di OpenAI mostra che nei contenuti poco flessibili (come la matematica) la rilevazione è molto più debole. Nei commenti e nella documentazione il segnale dovrebbe essere più forte che nel codice vero e proprio.
«Un sito dice di poter controllare il mio testo contro il watermark di ChatGPT.» Non usa il rilevatore di OpenAI. Non incollarci niente di riservato.
«Un “humanizer” o “remover” promette di togliere il watermark.» Alcuni forse lo attenuano, perché riscrivere molto lo indebolisce. Ma non puoi verificare il risultato, e la riscrittura può peggiorare il testo o infilarci qualche cavolata. Se l’obiettivo è un testo che suoni come te, rivederlo a mano è più economico e più sicuro.
«Un rilevatore ha segnato come IA un testo che ho scritto io.» Calma, e chiedi dettagli: quale rilevatore, quale soglia, quale lunghezza, quali altre prove oltre al punteggio. Un risultato di watermark è un indizio, non una sentenza. Porta con te le bozze e la cronologia delle versioni.
Cosa textGrain non può fare
- Non dimostra che ha scritto un umano. OpenAI lo dice senza giri di parole: la mancata rilevazione di un watermark non prova la paternità umana. Il testo può essere troppo breve, modificato, tradotto, di un altro fornitore o precedente al rollout.
- Non dice chi ha pensato. Un watermark non misura la parte umana. Chi ha avuto tutte le idee e ha fatto correggere la grammatica, per un rilevatore, somiglia a chi ha incollato un prompt.
- Non ti identifica. Secondo OpenAI non collega il testo a una persona, un account, un prompt o una conversazione.
- Non sopravvive a una modifica decisa. Con un quarto delle parole sostituito, la rilevazione di OpenAI scende al 17%.
- Non regge come prova in una disputa. I falsi positivi esistono (circa l'1% all’impostazione testata), attacchi di falsificazione sono stati dimostrati su altri metodi, e il rilevatore non è ancora stato valutato in modo indipendente.
Quello che può fare: aiutare piattaforme e ricercatori a individuare grandi volumi di testo di macchina non modificato, come spam, reti di bot e produzione di massa. È più vicino a ciò che vogliono i regolatori che a beccare un compito isolato.
Domande frequenti
ChatGPT metterà il watermark a tutti i miei testi? No. OpenAI dice che aggiungerà un watermark invisibile al testo idoneo di ChatGPT e Codex nell’UE, nelle prossime settimane. Non è un’impostazione globale predefinita. I clienti API di tutto il mondo possono attivarlo su modelli selezionati, disattivato di default.
Cos’è textGrain? Il metodo di watermark di testo di OpenAI. Pilota le scelte casuali del modello tra parole simili in modo che un rilevatore con una chiave segreta possa poi trovare uno schema statistico. Non aggiunge segni visibili né caratteri nascosti.
Qualcuno può controllare se il mio testo ha il watermark? Oggi no. OpenAI dà l’accesso al rilevatore, al lancio, solo a ricercatori e organizzazioni esperte approvati. I siti che offrono di verificare textGrain non usano il rilevatore di OpenAI.
Il watermark rivela chi sono o cosa ho scritto nel prompt? Secondo OpenAI no. Il watermark non collega il testo a una persona, un’organizzazione, un account, un prompt o una conversazione, e il rilevatore segnala solo se trova un watermark di OpenAI.
Posso disattivarlo? L’annuncio di OpenAI non descrive un’impostazione utente per ChatGPT nell’UE. L’azienda dice che «quando possibile» vuole dare una scelta. I clienti API possono attivarlo nelle impostazioni del progetto o dell’organizzazione. Che «non si possa spegnere» non è né confermato né smentito dalle pagine di OpenAI.
Modificare il testo elimina il watermark? Lo indebolisce. Nel test di OpenAI su testi da 400 token, la rilevazione è scesa da circa il 92% a circa il 66% sostituendo il 10% delle parole, e a circa il 17% con il 25%. Una riscrittura profonda o una traduzione possono renderlo introvabile.
Il mio professore o il mio datore di lavoro possono beccarmi con questo? Non con il rilevatore di OpenAI, a cui non hanno accesso. E anche se lo avessero, OpenAI dice che un risultato non indica quanta parte del testo fosse umana, di chi sia, né se sia stata violata una regola.
Il watermark di Claude è diverso? Sì. Anthropic dice che il suo watermark, una variante del SynthID-Text di Google, si applica in tutto il mondo ai modelli Claude recenti compatibili, non solo nell’UE. Quello di OpenAI è regionale e il rilevatore è limitato.
Perché prima l’UE? Perché l’articolo 50, paragrafo 2, dell’AI Act obbliga dal 2 agosto 2026 i fornitori a marcare il testo sintetico in modo leggibile dalle macchine. Un termine fino al 2 dicembre 2026 per i sistemi già sul mercato spiega il rollout graduale.
Devo smettere di usare ChatGPT per scrivere? No. Il rischio pratico non è il watermark, ma far passare l’aiuto di un’IA per lavoro tuo dove le regole lo vietano. Usa l’IA, rivedi il testo finché è davvero tuo, tieni le bozze e rispetta le regole del tuo ateneo o della tua azienda.
In sintesi
textGrain è un cambiamento vero, ma più piccolo e più prudente di quanto dicano i titoli. I testi di ChatGPT e Codex nell’UE riceveranno nelle prossime settimane un segnale statistico invisibile. Fuori dall’UE non sei nel rollout predefinito. A parte un piccolo gruppo di ricercatori approvati, nessuno può verificarlo. E i numeri di OpenAI mostrano quanto in fretta svanisce: con un quarto delle parole cambiato, la rilevazione resta intorno al 17%.
Quindi né panico né trucchetti. Capisci cos’è, rispetta le regole a cui sei davvero vincolato e documenta come hai usato l’IA. Una breve nota sull’uso e una cartella di bozze datate valgono più di qualunque risultato di watermark, a favore o contro di te.
Se vuoi usare l’IA con sicurezza al lavoro e all’università, il corso Alfabetizzazione IA (art. 4 AI Act) spiega le regole senza legalese, Fondamenti di IA mostra cosa sanno e non sanno fare questi strumenti, e Prompt efficaci per ChatGPT ti aiuta a ottenere bozze che poi puoi davvero fare tue. Per capire la differenza tra un watermark e un rilevatore di IA, la nostra voce di glossario What Is an AI Text Watermark? (in inglese) fa il quadro.
Fonti
- OpenAI, «Our approach to EU text provenance rules» (5 ottobre 2026)
- OpenAI Help Center, «Provenance signals in OpenAI-generated content»
- OpenAI, rapporto tecnico textGrain «Entropy-calibrated watermarking for language model text»
- Blog.it, «OpenAI inizia a marchiare con watermark il testo di ChatGPT nell’UE»
- TechCrunch, «OpenAI will start watermarking ChatGPT’s text in the EU» (5 ottobre 2026)
- Cybersecurity360, «Contenuti generati dall’AI: watermark obbligatori ma la tecnologia non basta» (1 giugno 2026)
- Orizzonte Scuola, «Intelligenza artificiale, l’Italia è penultima in Europa: solo il 19,9% degli adulti usa questi strumenti» (dati Istat 2025)
- Agenda Digitale, «Legge 132/2025 e uso dell’AI nella pubblica amministrazione»
- Studio Cataldi, «Legge 132/2025 e intelligenza artificiale: prime osservazioni»
- AI Act, articolo 50: obblighi di trasparenza
- Consiglio d’Europa/MERLIN, codice di buone pratiche sulla trasparenza dei contenuti generati dall’IA
- Cloud Security Alliance, nota sulla scadenza dell’articolo 50 a dicembre 2026
- Jovanović, Staab e Vechev (ETH Zurigo), «Watermark Stealing in Large Language Models»
- Google DeepMind, SynthID-Text (Nature)